
机器学习十大核心算法全解析:从数据到模型的实战指南
在机器学习领域,有一个公式被反复提及——"数据+算法=模型"。
这看似简单的等式,却道出了项目成功的核心密码。对于数据科学家而言,选择合适的算法就像厨师挑选合适的食材,经验越丰富,做出的"菜肴"就越精准高效。
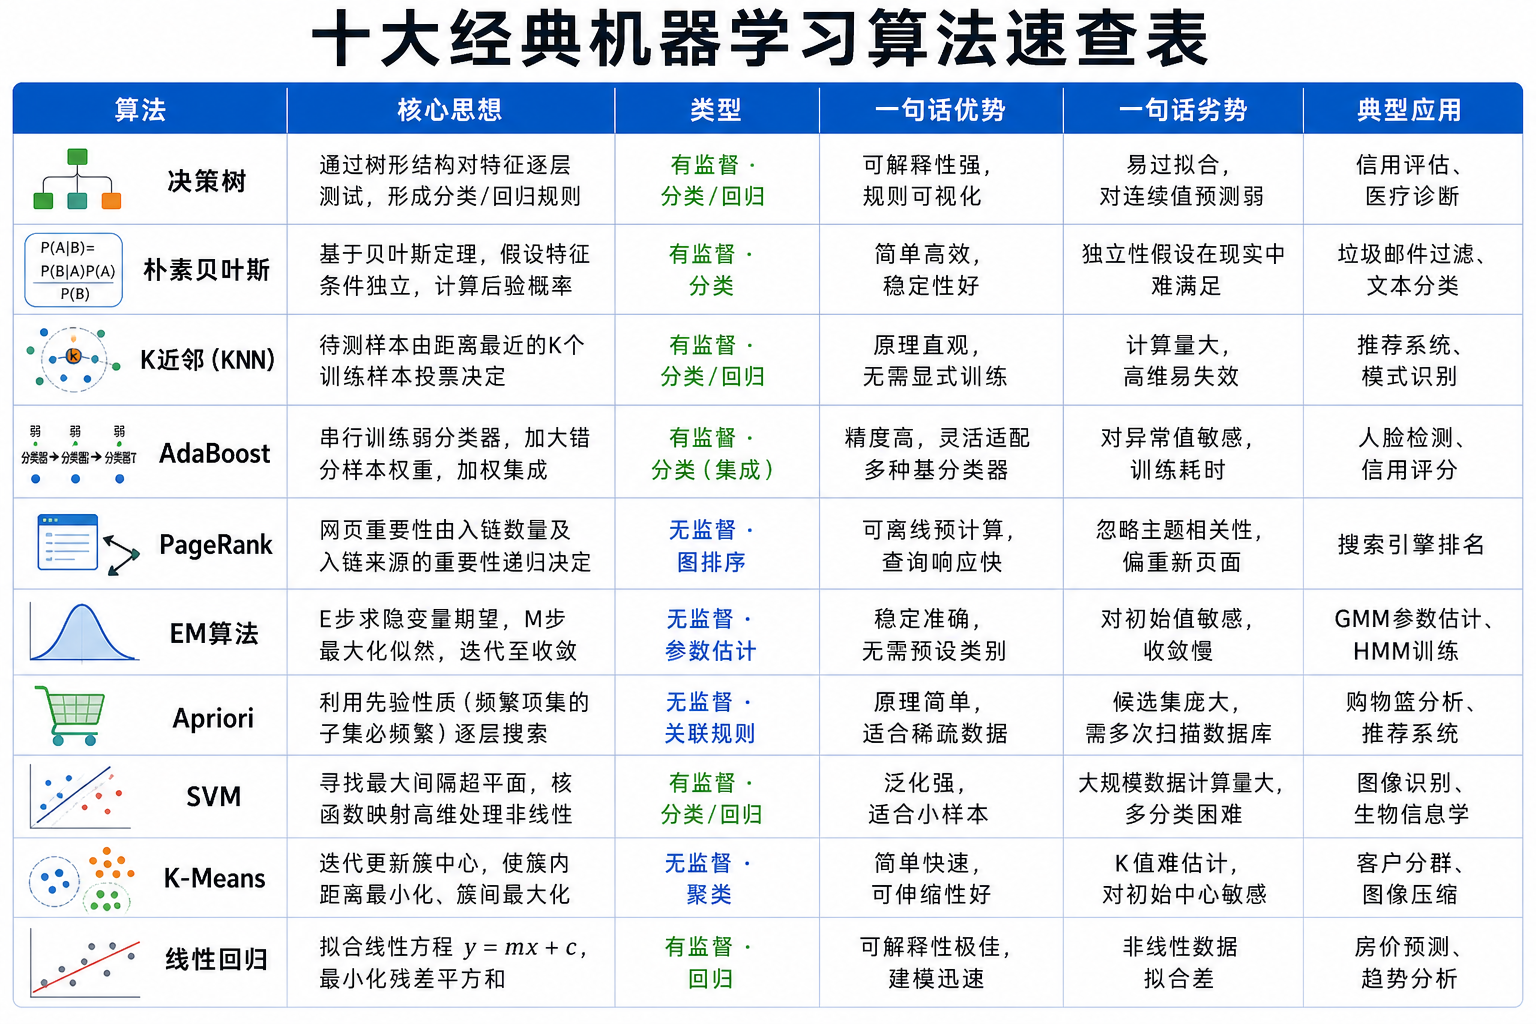
今天,我们就来系统梳理机器学习领域最具影响力的十大经典算法,深入解析它们的设计思想、优劣势与典型应用场景。
01 决策树:最"人性化"的分类器
决策树是一种模拟人类决策逻辑的树形结构。每个内部节点代表对某个特征的测试,每个分支代表测试结果,每个叶节点则代表最终的类别判定。
构建三步骤:
特征选择:从众多特征中挑选最优划分依据。不同的筛选标准衍生出ID3、C4.5、CART等不同变体。
树生成:从根节点开始递归生长,直至数据不可再分。
剪枝:为了防止模型"死记硬背"训练数据(过拟合),需要剪掉一些枝叶。分为预剪枝和后剪枝两种策略。
树模型 vs 线性模型:本质差异在哪?
线性模型(如逻辑回归)是将所有特征加权求和,然后映射到概率空间,通过概率阈值划分类别——它找到的是线性分割面。而树模型逐个特征处理,一层层划分,找到的是非线性分割。
更重要的是,树模型的决策路径与人类思维方式高度契合——看得懂、说得清,天然具备可解释性。
优势: 训练预测速度快;对数据预处理要求低;规则可视化,易于理解。
劣势: 对连续型数据预测能力有限;容易过拟合;样本不平衡时,信息增益会偏向取值较多的特征。
C4.5:数据挖掘界的"状元"
C4.5在2006年被数据挖掘国际会议ICDM评为十大经典算法第一名。它是ID3的升级版,核心改进包括:
用信息增益率代替信息增益,校正了对多值特征的偏好
引入剪枝策略
支持连续属性离散化
能处理不完整数据
CART:二分类的"二叉树"专家
CART(分类与回归树)由Breiman等人于1984年提出,强制生成满二叉树——每个节点只能产生"是"与"否"两个分支。它能同时处理分类与回归问题,连续变量通过二元切分来处理。
02 朴素贝叶斯:以"天真"之姿行高效之事
贝叶斯分类家族的理论基石是贝叶斯定理。而朴素贝叶斯是其中最简单、最常见的一员。
它的"朴素"之处在于一个大胆的假设:所有特征之间相互独立。在这个前提下,联合概率的计算变得异常简单。
判别模型 vs 生成模型:
像KNN、逻辑回归、决策树这类模型属于判别模型——直接学习特征X与输出Y之间的映射关系。而朴素贝叶斯属于生成模型——先学习联合分布P(X,Y),再推导出后验概率P(Y|X)。
优势: 逻辑简单,算法稳定,对不同数据集的适应性强,鲁棒性好。当特征独立性假设成立时,效果尤其出色。
劣势: 现实世界中特征往往相互关联,"独立性假设"常常难以满足,这时分类效果会大打折扣。
03 KNN:用"朋友圈"投票做决策
KNN(K近邻算法)是机器学习中最简洁的算法之一。它的核心思想是近朱者赤,近墨者黑——一个未知样本的类别,由它在训练集中最近的K个"邻居"投票决定。
K值的选择是预测精度的关键命门。
距离的度量在低维空间很直观,但在高维空间可能会失效——这就是著名的"维度灾难"。因此,使用KNN前需要进行特征筛选,只保留与预测目标最相关的变量。
优势: 原理简单,易于实现,无需训练过程(属于"懒散学习")。
劣势: 对不平衡数据敏感,大类别容易"淹没"小类别;预测时需要计算与所有样本的距离,计算量大;高维数据下距离度量失效。
04 AdaBoost:从"错题集"中炼出学霸
Boosting是一种集成学习策略——把多个"弱分类器"组合成一个"强分类器"。AdaBoost是第一个真正成功的Boosting算法,专为二分类问题而生。
它的运作机制可以用一个生动的比喻来理解:
做对的题目,下次少练一些,反正已经掌握了
做错的题目,下次多练一些,集中火力攻克难点
随着迭代推进,错题越来越少
具体流程上,AdaBoost先训练第一个弱分类器,然后提高错分样本的权重,让下一个分类器"重点关照"这些难题。如此迭代,最后将所有弱分类器按精度加权组合成强分类器。
优势: 巧妙利用弱分类器级联;精度高;充分考虑了每个基分类器的贡献差异。
劣势: 弱分类器个数(迭代次数)不易确定,常用交叉验证调优;数据不平衡时效果下降;训练耗时较长。
05 PageRank:谷歌崛起的"核武器"
PageRank是谷歌创始人拉里·佩奇和谢尔盖·布林的成名之作。他们的灵感来源于学术论文引用体系——一篇论文被引用次数越多,说明它越重要。
将这个逻辑迁移到网页世界就形成了PageRank的核心思想:
被大量网页链接的网页,重要性更高,PageRank值更大
被高PageRank值网页引用的网页,其PageRank值也会随之提升
优势: 静态算法,所有网页的PR值可离线预计算,极大降低在线查询响应时间。
劣势: 忽略主题相关性,可能导致搜索结果偏离用户意图;新页面天然劣势,因为没有足够的历史链接积累。
06 EM算法:迭代优化的"厨艺大师"
EM(期望最大化)算法的正式提出可追溯至1977年,由Dempster、Laird和Rubin三人完成。它专门解决含有隐变量时的参数估计问题,在高斯混合模型、隐马尔可夫模型、LDA主题模型中都有广泛应用。
EM包含两个交替进行的步骤:
E步(期望步):在现有参数估计下,计算隐变量的期望值
M步(最大化步):利用E步结果,最大化似然函数来更新参数
一个厨房里的比喻:
厨师炒了一盘菜,要平分到两个碗里。不用天平,最简单的办法是——先随便分,然后看哪个碗多了就匀一点到少的碗里。反复调整,直到肉眼看不出差别为止。EM算法的逻辑正是如此。
优势: 算法稳定、准确;无需预设类别数,能自收敛。
劣势: 对初始值敏感;计算复杂,收敛较慢,不适合大规模高维数据;目标函数非凸时容易陷入局部最优解。
07 Apriori:挖掘"啤酒与尿布"的秘密
Apriori算法是关联规则挖掘的开山之作,由Rakesh Agrawal等人提出。最经典的案例就是购物篮分析——买尿布的顾客往往也会买啤酒。
算法的核心是先验性质:
一个频繁项集的所有非空子集也必须是频繁的
反之,非频繁项集的任何超集都是非频繁的
基于这个性质,算法采用逐层搜索的迭代方式:从1-项集开始,逐级生成2-项集、3-项集……每生成一级需要扫描一次数据库。
优势: 原理简单,易于实现;适合稀疏数据集(如购物篮数据)。
劣势: 可能产生天文数字般的候选集;需要反复扫描数据库,效率较低,耗时巨大。
08 SVM:小样本下的"分类之王"
支持向量机(SVM)的核心目标是找到一个最大间隔超平面,将不同类别的样本以最宽的"安全距离"隔开。
对于线性不可分的问题,SVM通过核函数将数据映射到高维空间,在这个新空间里寻找线性分割。
SVM有三个关键构件:
最大间隔:衡量分类边界的"宽度",越宽泛化能力越强
高维映射:处理非线性问题的核心手段
核函数:决定了映射的方式与效果
优势: 泛化能力强,尤其适合小样本场景;核函数机制可灵活处理非线性问题;模型简洁,仅依赖少数的支持向量。
劣势: 大规模训练样本下计算量巨大;原始SVM不直接支持多分类;对缺失数据和超参数选择敏感。
09 K-Means:最经典的"物以类聚"算法
K-Means是聚类分析领域最具代表性的算法之一。它的目标是将数据划分为K个簇,使得簇内样本尽可能"近",簇间样本尽可能"远"。
迭代四步骤:
随机选取K个对象作为初始聚类中心
计算每个对象到各中心的距离,分配到最近的簇
重新计算每个簇的均值作为新中心
重复2和3,直到中心不再变化或达到迭代上限
优势: 算法简单,收敛迅速;对大数据集具有良好的可伸缩性;当数据簇呈类高斯分布时效果理想。
劣势: K值需预先设定,难以估计最优值;对初始中心选择极其敏感,易陷入局部最优;对噪声和异常值敏感;数据量大时计算开销高。
10 线性回归:最朴素的"预测担当"
线性回归是统计学与机器学习中最基础的回归方法。它的目标是找到一条"最佳拟合线"来描述自变量与因变量之间的关系。
基本形式为 y = mx + c,其中y是因变量,x是自变量。建模过程就是利用给定的数据集来求解m和c的最优值。
线性回归包含两种类型:
简单线性回归:只有1个自变量
多元线性回归:包含2个及以上自变量
优势: 思想直观,建模快速;模型可解释性强;是许多复杂非线性模型的基础。
劣势: 对非线性数据拟合能力不足;特征间存在相关性时估计不稳定;难以表达高度复杂的函数关系。
评论
安
干货推荐
神经元、星形胶质细胞、少突胶质细胞、小胶质细胞组织学区分
Mr弘🔬
90 7
lammps中文教程5
春风得意马蹄疾
48 2
计算机材料设计Materials-Studio教程5
活着
33 2
计算机材料设计Materials-Studio教程12
活着
44 2
免疫荧光染色全流程
7330a6d4
34 1
分子动力学模拟:从原始轨迹到科学结论的推理路径解析
吃鱼不
123 3