
带你捋一捋分子动力学模拟的“知识地图”
刚踏入分子动力学这个圈子的朋友,十有八九会有种“乱花渐欲迷人眼”的感觉。今天啃一个算法,明天试一个软件功能,后天又冒出一个新概念,回头一想,脑子里的知识就像一团缠在一起的耳机线,理也理不清。别慌,这太正常了!
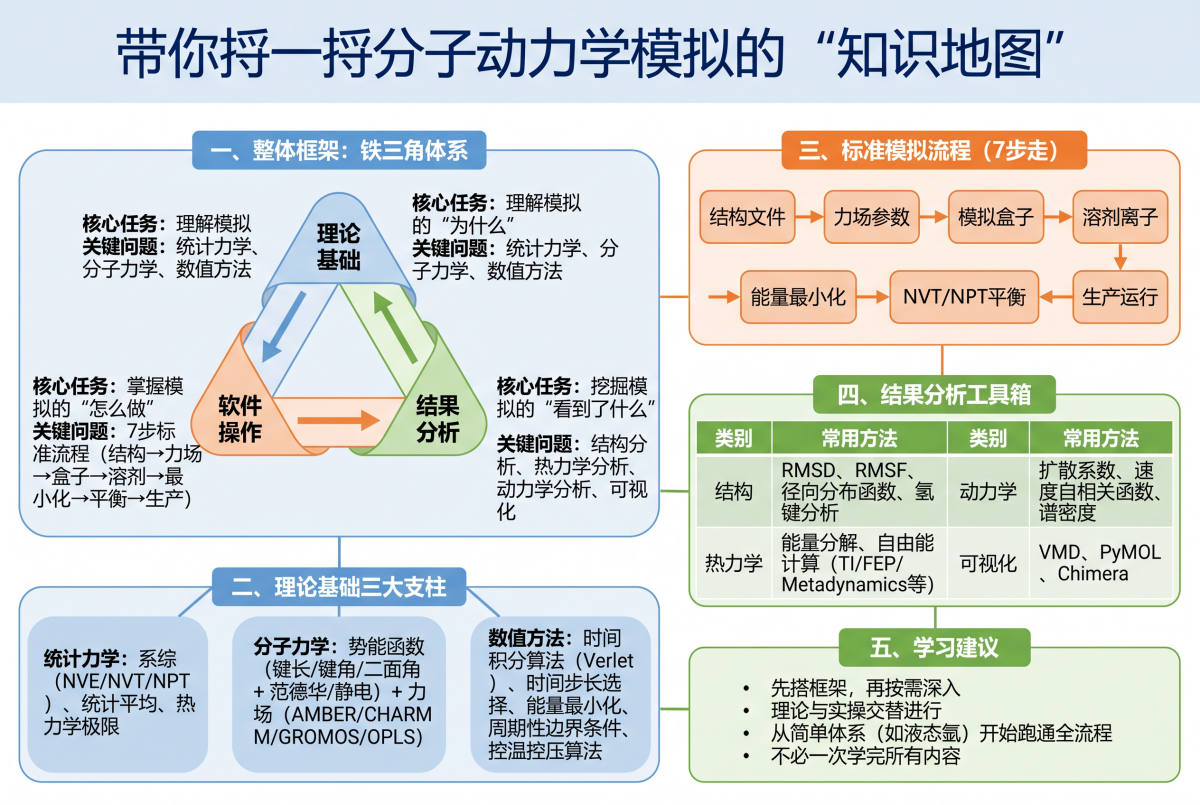
往根儿上说,分子动力学模拟是一门十足的“应用手艺”。它的“内功心法”是统计力学,手里的“工具”是计算机,最终目标是用模拟出的结果去解答具体的科学谜题。这三个板块——理论基石、软件实操和结果解读,可不是各玩各的,而是环环相扣的铁三角。理论告诉你“为什么能这么做”,软件帮你“把想法跑起来”,分析则让你明白“到底得到了什么”。哪一环掉了链子,整个活儿可能就砸了。
第一块基石:理论基础——搞懂模拟的“为什么”
这部分是很多人觉得头大但又绕不开的“硬骨头”。
统计力学:模拟的“世界观”
MD模拟的是海量粒子的集体行为,所以统计力学就是它的理论根基。咱没必要像物理专业那样啃完一整本教材,但有几个核心概念得刻在脑子里。
首先是系综。你可以把它想象成在特定宏观条件(比如温度、体积、粒子数固定)下,体系所有可能微观状态的大集合。我们常说的NVE、NVT、NPT,就是三种经典系综。NVE(微正则系综)能量守恒,适合描述孤立系统;NVT(正则系综)温度恒定,粒子数和体积也不变;NPT(等温等压系综)则让温度和压力都保持恒定,这最接近咱们烧杯或培养皿里的真实实验条件。要是系综选错了,模拟结果就可能跟实际情况南辕北辙,好比拿个体温计去量血压,读数再精确也没用。
接着是统计平均。模拟跑出来的一条轨迹,本质上是体系在“相空间”里走过的一条路径。但我们真正关心的往往是宏观性质,比如密度、扩散系数、热容,这些都得通过对轨迹进行统计平均来获得。不同系综下的平均玩法略有不同。在NVT系综里,跑的时间越长,时间平均就越接近于系综平均,结果也就越靠谱。NPT系综嘛,还得额外考虑体积的涨落,稍微复杂一丢丢。
还有个容易混淆的概念叫热力学极限。我们模拟的体系粒子数总是有限的,可能几千个,撑死几十万个。但我们想要的常常是热力学极限下的性质,也就是粒子数趋向无穷大时的表现。这两者有偏差,粒子数越少,涨落就越明显。所以在分析结果时,心里要时刻绷着一根弦:我的结果受不受“有限尺寸效应”的影响?
分子力学:模拟的“物理模型”
你可以把分子想象成一套用弹簧连接起来的小球。分子的总能量大致由两部分“拼图”组成:一部分是化学键的贡献,包括键长拉伸、键角弯曲、二面角扭转;另一部分是非键合相互作用,也就是范德华力和静电相互作用。每种贡献都有对应的数学形式,也就是势能函数。
举个例子,键长拉伸通常用简谐势描述,就像弹簧一样,偏离平衡位置越远,能量越高,弹簧就越想把人拉回来。键角弯曲也类似。而二面角扭转则复杂些,涉及四个原子的相对取向,常用傅里叶级数来描述,不同的扭转角度对应不同的能量,这决定了分子更喜欢“凹”哪种造型。
非键合作用中,范德华力一般用Lennard-Jones势来描绘,简单说就是原子离太近就使劲排斥,离太远又轻轻吸引,它们之间的“舒适距离”大概在3-4埃,这也就是原子“半径”的由来。静电相互作用就是库仑定律,同号电荷相斥,异号电荷相吸。
理解了这些势能函数,你就懂了分子力学的核心。但光知道形式不够,还得知道参数从哪来。这就引出了力场。力场就是一套势能函数加参数,用来描述特定原子间的“相处之道”。常见的力场像AMBER、CHARMM、GROMOS、OPLS等,各有各的“人设”和擅长领域。AMBER最早为生物分子而生;CHARMM历史悠久,参数覆盖广;GROMOS追求效率,参数简洁;OPLS则特别注重与实验热力学数据的匹配。不同力场的区别,本质上是参数化方法和数据来源(量子化学计算、实验数据或两者结合)的差异。拿到一个力场,你得知道它适合啥体系,不适合啥体系,心里有本账。
数值方法:模拟的“操作手册”
MD本质上就是数值求解牛顿方程,这就涉及到算法。
最核心的时间积分算法,经典的是Verlet算法。思路是用当前的位置和速度,通过泰勒展开近似,算出下一步的位置。但它不自启动,得额外给个初始速度。后来有了Velocity Verlet和Leap-frog等变体,形式更对称或更高效。别纠结用哪个,理解思想最重要——都是用当前信息去预测未来。
时间步长的选择是个技术活。步长太小,效率低;步长太大,误差积累会导致体系“爆炸”。一般取系统最快运动周期的十分之一左右。含氢体系振动周期约10飞秒,所以步长常用1飞秒。粗粒化模型没有氢原子,步长可用到10-20飞秒。
正式跑模拟前,得先做能量最小化,消除不合理的高能接触,好比剧烈运动前先热身,避免一上来就“抽筋”。常用最速下降法先快速消除严重冲突,再用共轭梯度法精细优化。
边界条件也很重要。为了消除边界效应,常用周期性边界条件,即把模拟盒子像拼瓷砖一样无限复制。粒子从一边跑出去,就从对边钻进来。这要求相互作用不能超出盒子范围,所以必须引入截断半径,之外的相互作用就忽略掉。截断半径的选择要在计算量和准确性之间权衡。
最后,控温和控压算法也是数值方法的一部分。比如Berendsen控温比较“温和”,适合预平衡阶段;Nosé-Hoover更严格,适合正式采样阶段。具体用哪个,看你的研究目的。
第二块拼图:软件操作——掌握模拟的“怎么做”
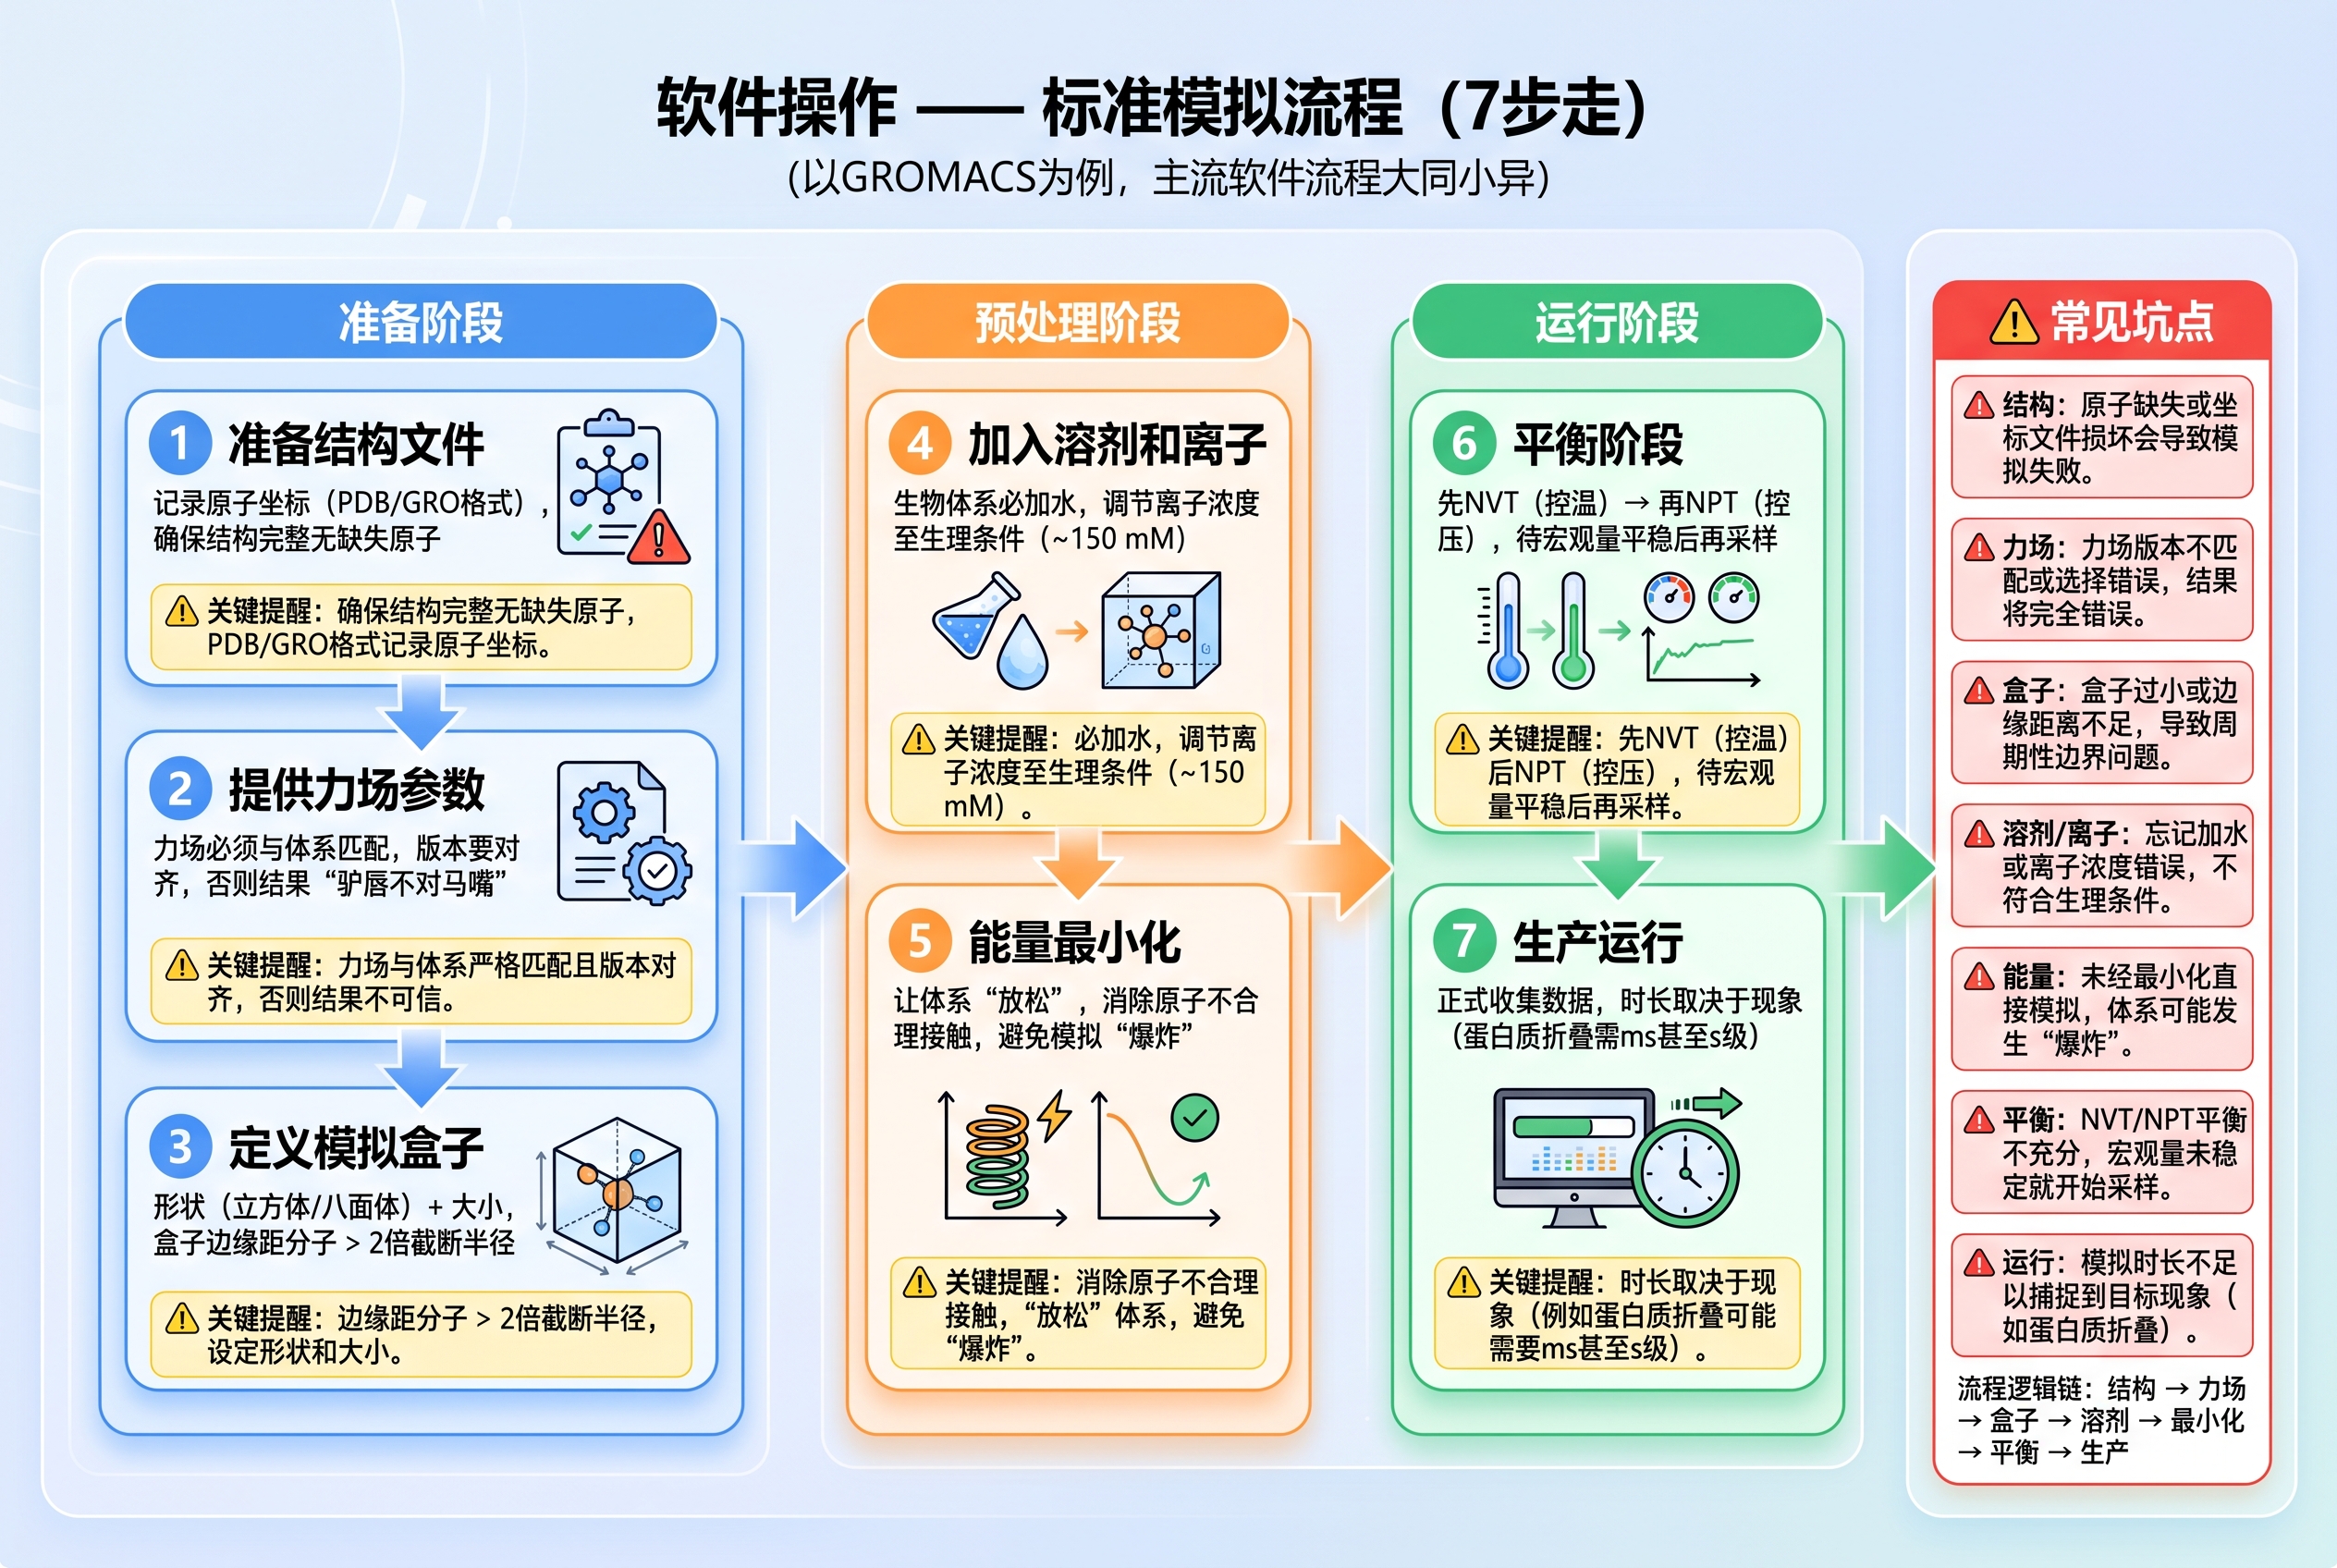
理论再懂,最终也得落实到怎么跑模拟。主流软件各有千秋,但基本流程大同小异。以GROMACS为例,完整流程大致如下:
准备结构文件:记录分子的原子坐标,常用PDB、GRO等格式。
提供力场参数:指定体系用哪个力场,注意版本要匹配,不然结果可能“驴唇不对马嘴”。
定义模拟盒子:选盒子形状(立方体、八面体等)和大小。原则是盒子边缘到最近分子的距离要大于截断半径的两倍,避免周期性镜像干扰。
加入溶剂和离子:生物体系别忘了加水,并调节离子浓度至生理条件(约150 mM)。
能量最小化:让体系“放松”一下,消除不合理的原子接触。
平衡阶段:先进行NVT平衡(控温),再进行NPT平衡(控压),让体系逐步适应目标环境。别急着采样,等温度、压力、能量等宏观量波动平稳下来再说。
生产运行:正式开始收集数据。跑多久取决于你关心的现象,蛋白质折叠可能需要毫秒甚至秒级模拟,这需要经验和对计算资源的权衡。
第三块宝藏:结果分析——挖掘模拟的“看到了什么”
模拟跑完,真正的“挖宝”才开始。
结构分析是基础。RMSD(均方根偏差)衡量结构相对于参考构象的偏离程度,数值小说明结构稳定。RMSF(均方根涨落)描述每个原子或残基的柔性,数值大说明这部分更“活泛”。径向分布函数告诉你特定原子对间的距离分布,峰值对应着有序结构(如水分子第一溶剂化层)。氢键分析则用来判断氢键的形成,这是维持蛋白质二级结构(α螺旋、β折叠)的关键。
主成分分析是个有趣的方法,它把复杂的轨迹投影到低维空间,找出变化最大的几个“主模式”,帮你抓住体系最显著的运动特征(比如蛋白质的“呼吸运动”)。
热力学分析方面,能量分解可以告诉你各能量成分(键、角、范德华、静电)的贡献大小,从而理解稳定性的来源。自由能计算更高级,像药物-蛋白质结合自由能,没法直接得到,得用热力学积分、自由能扰动、Metadynamics等特殊方法。它们核心思想相通,即通过增强采样来更全面地探索相空间,再用统计力学计算自由能。
动力学分析关注时间演化。扩散系数可由均方根位移随时间的变化算出,反映粒子运动快慢。速度自相关函数描述速度在时间上的关联,其衰减快慢反映了弛豫过程,还能通过傅里叶变换得到谱密度,了解不同频率的振动贡献。
最后,别忘了可视化。用VMD、PyMOL等工具查看轨迹,不仅能检查模拟是否正常,还是展示成果、制作论文插图的神器。
好啦,MD的主要知识框架就梳理到这。回头看,理论、操作、分析,三者紧密相连。内容虽多,但别指望一口吃成胖子。我的建议是先搭好框架,再按需深入。理论学习与上机实操交替进行,效果最好。比如,你可以先跑一个最简单的体系(比如几个氩原子在盒子里的模拟),把整个流程跑通,过程中遇到的问题会反过来加深你对理论的理解。这样“实践-理论-再实践”几个来回,感觉就慢慢来了。入门阶段,别追求全知全能,享受探索的乐趣最重要!
评论
会魔法的猫
干货推荐
研究生有限元复习重点
爽子
67 6
血脑屏障超微结构
Mr弘🔬
118 9
模态分析到底在算啥?搞懂这个,结构为什么会自己振动就明白了
莫名其妙
63 4
分子动力学模拟:从原始轨迹到科学结论的推理路径解析
吃鱼不
123 3
计算机材料设计Materials-Studio教程12
活着
44 2
这些真的是棕色脂肪吗?
Mr弘🔬
164 2