
机器学习、深度学习、大模型:到底啥关系?
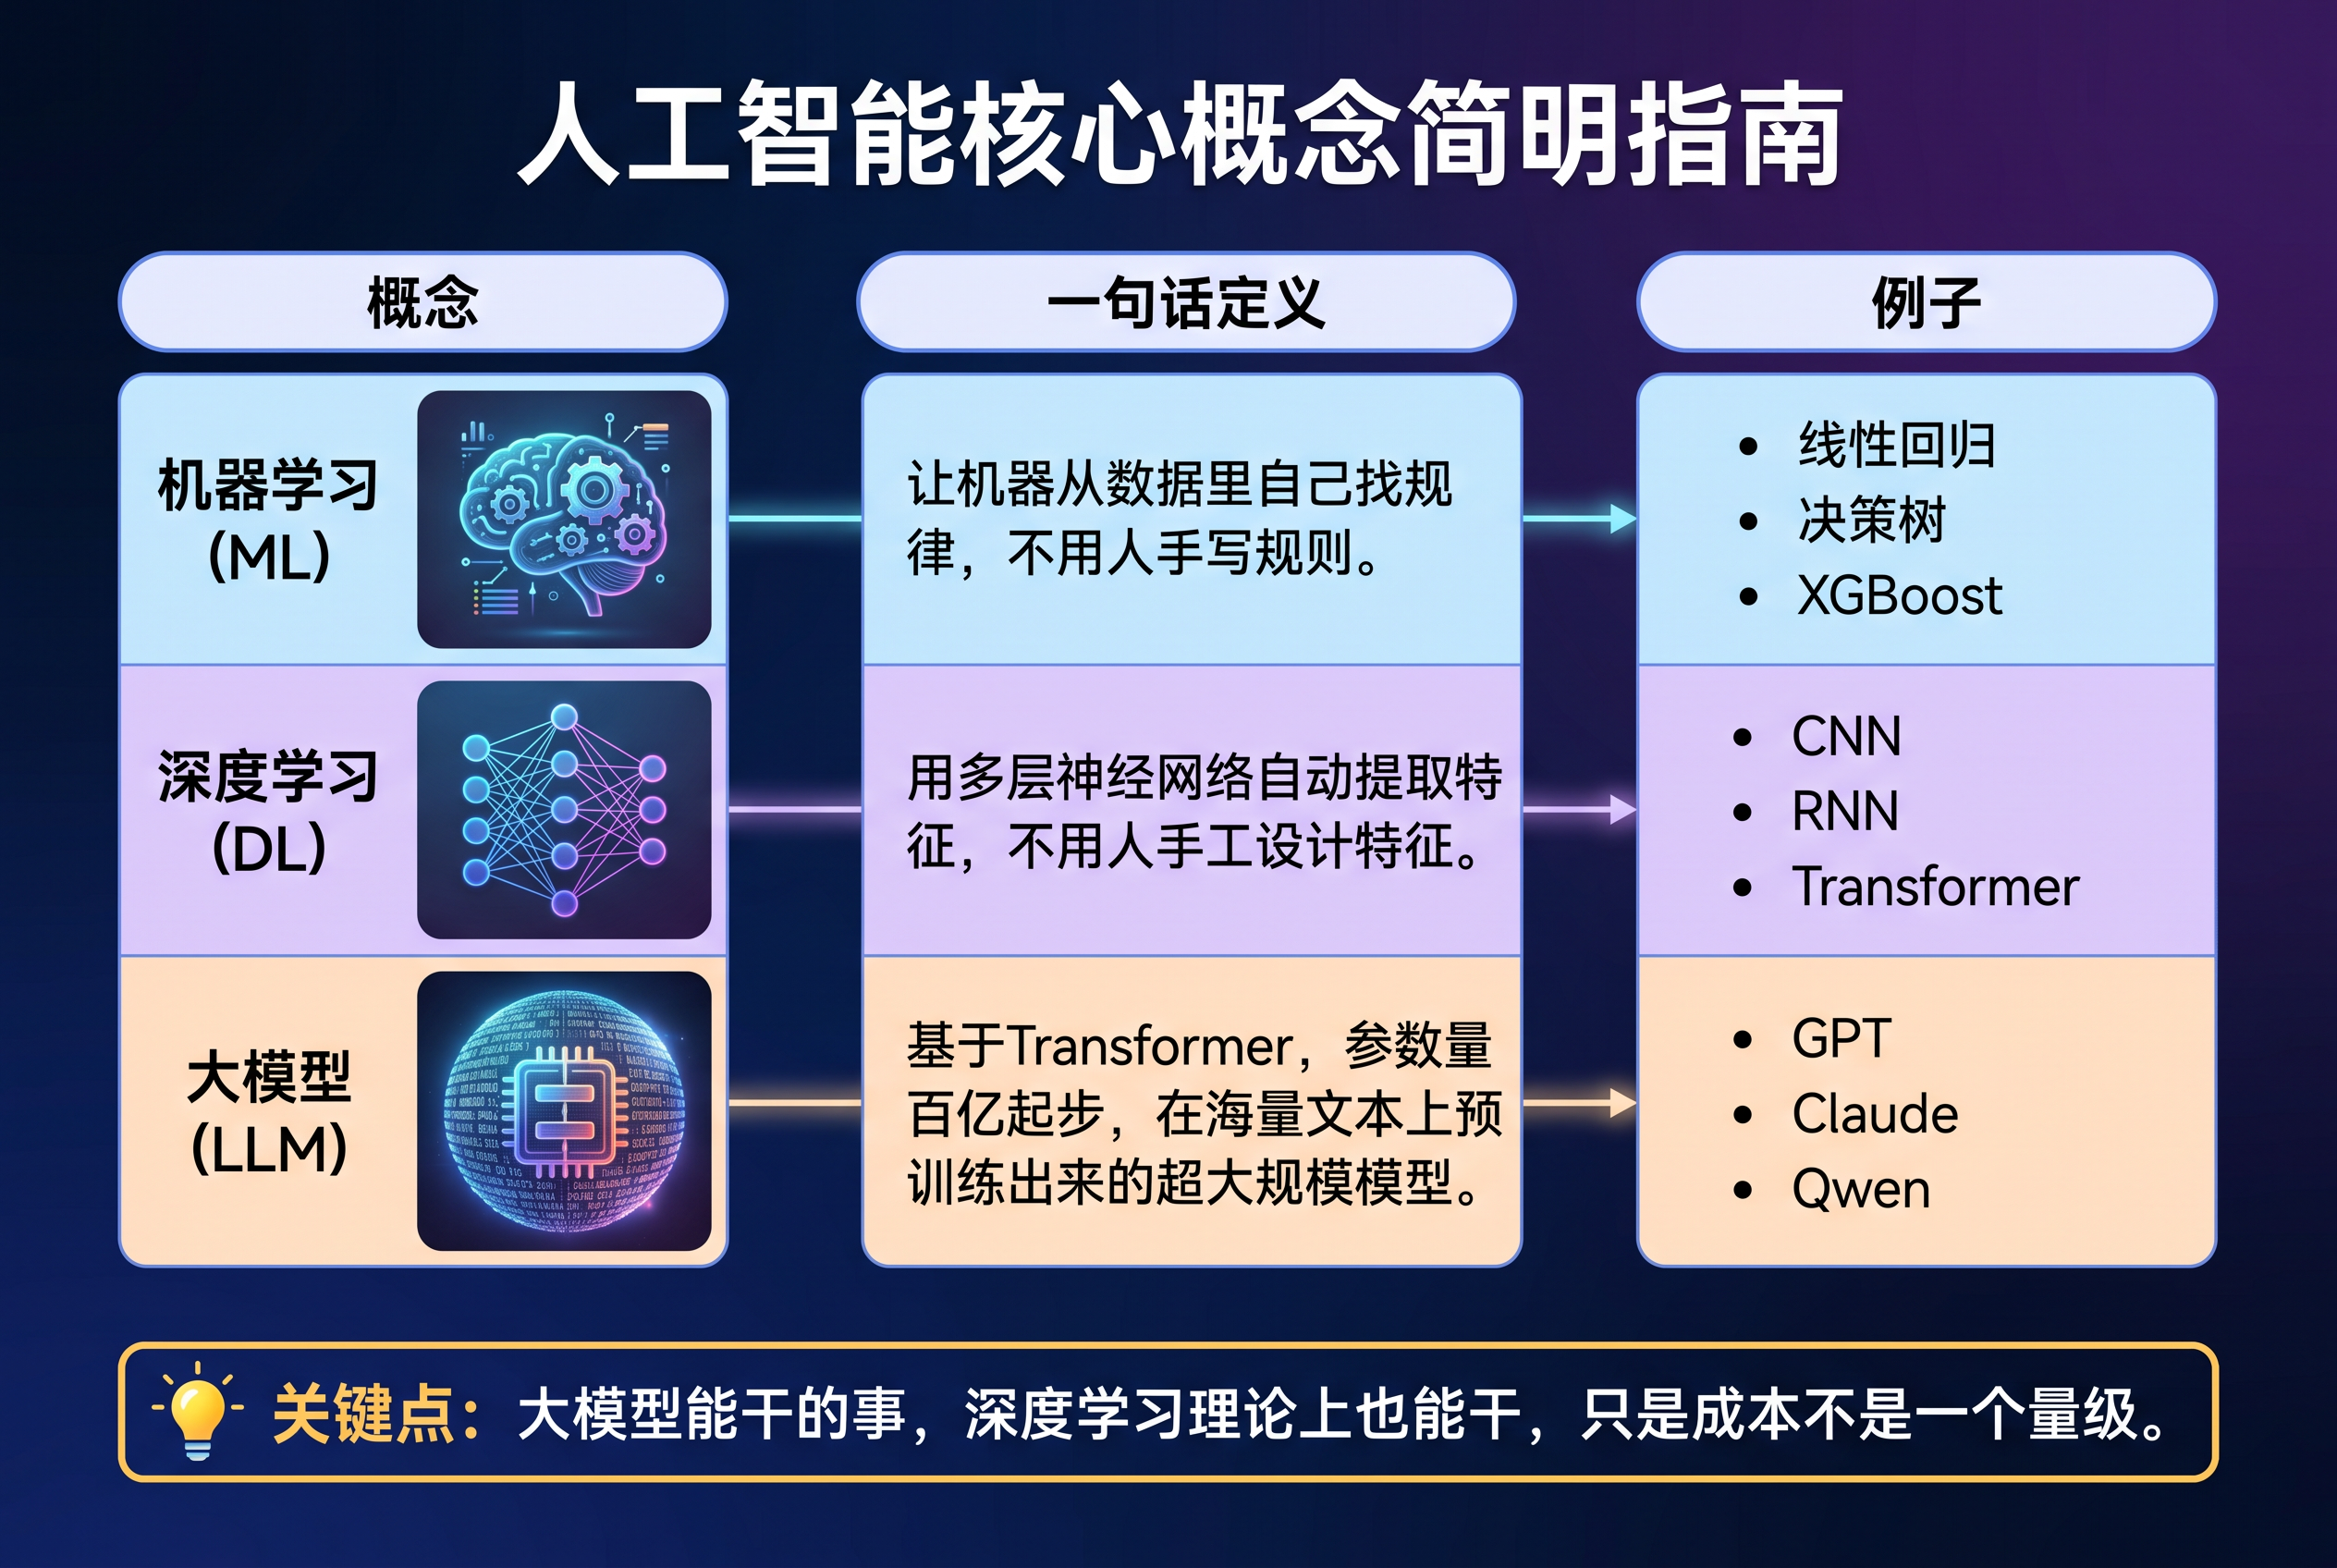
先上结论:这三者是层层包含的关系,不是并列的。
机器学习(ML) 是总称 → 深度学习(DL) 是ML的一个子集 → 大模型(LLM) 是DL的一个特例(规模贼大那种)。
一、一句话说清楚它们分别是啥
| 概念 | 一句话定义 |
| 机器学习 (ML) | 让机器从数据里自己找规律,不用人手写规则。包括线性回归、决策树、XGBoost这些。 |
| 深度学习 (DL) | 用多层神经网络自动提取特征,不用人手工设计特征。典型代表:CNN、RNN、Transformer。 |
| 大模型 (LLM) | 基于Transformer,参数量百亿起步,在海量文本上预训练出来的超大规模模型。比如GPT、Claude、Qwen。 |
关键点:大模型能干的事,深度学习理论上也能干,只是成本不是一个量级。
二、核心差异(一张表看明白)
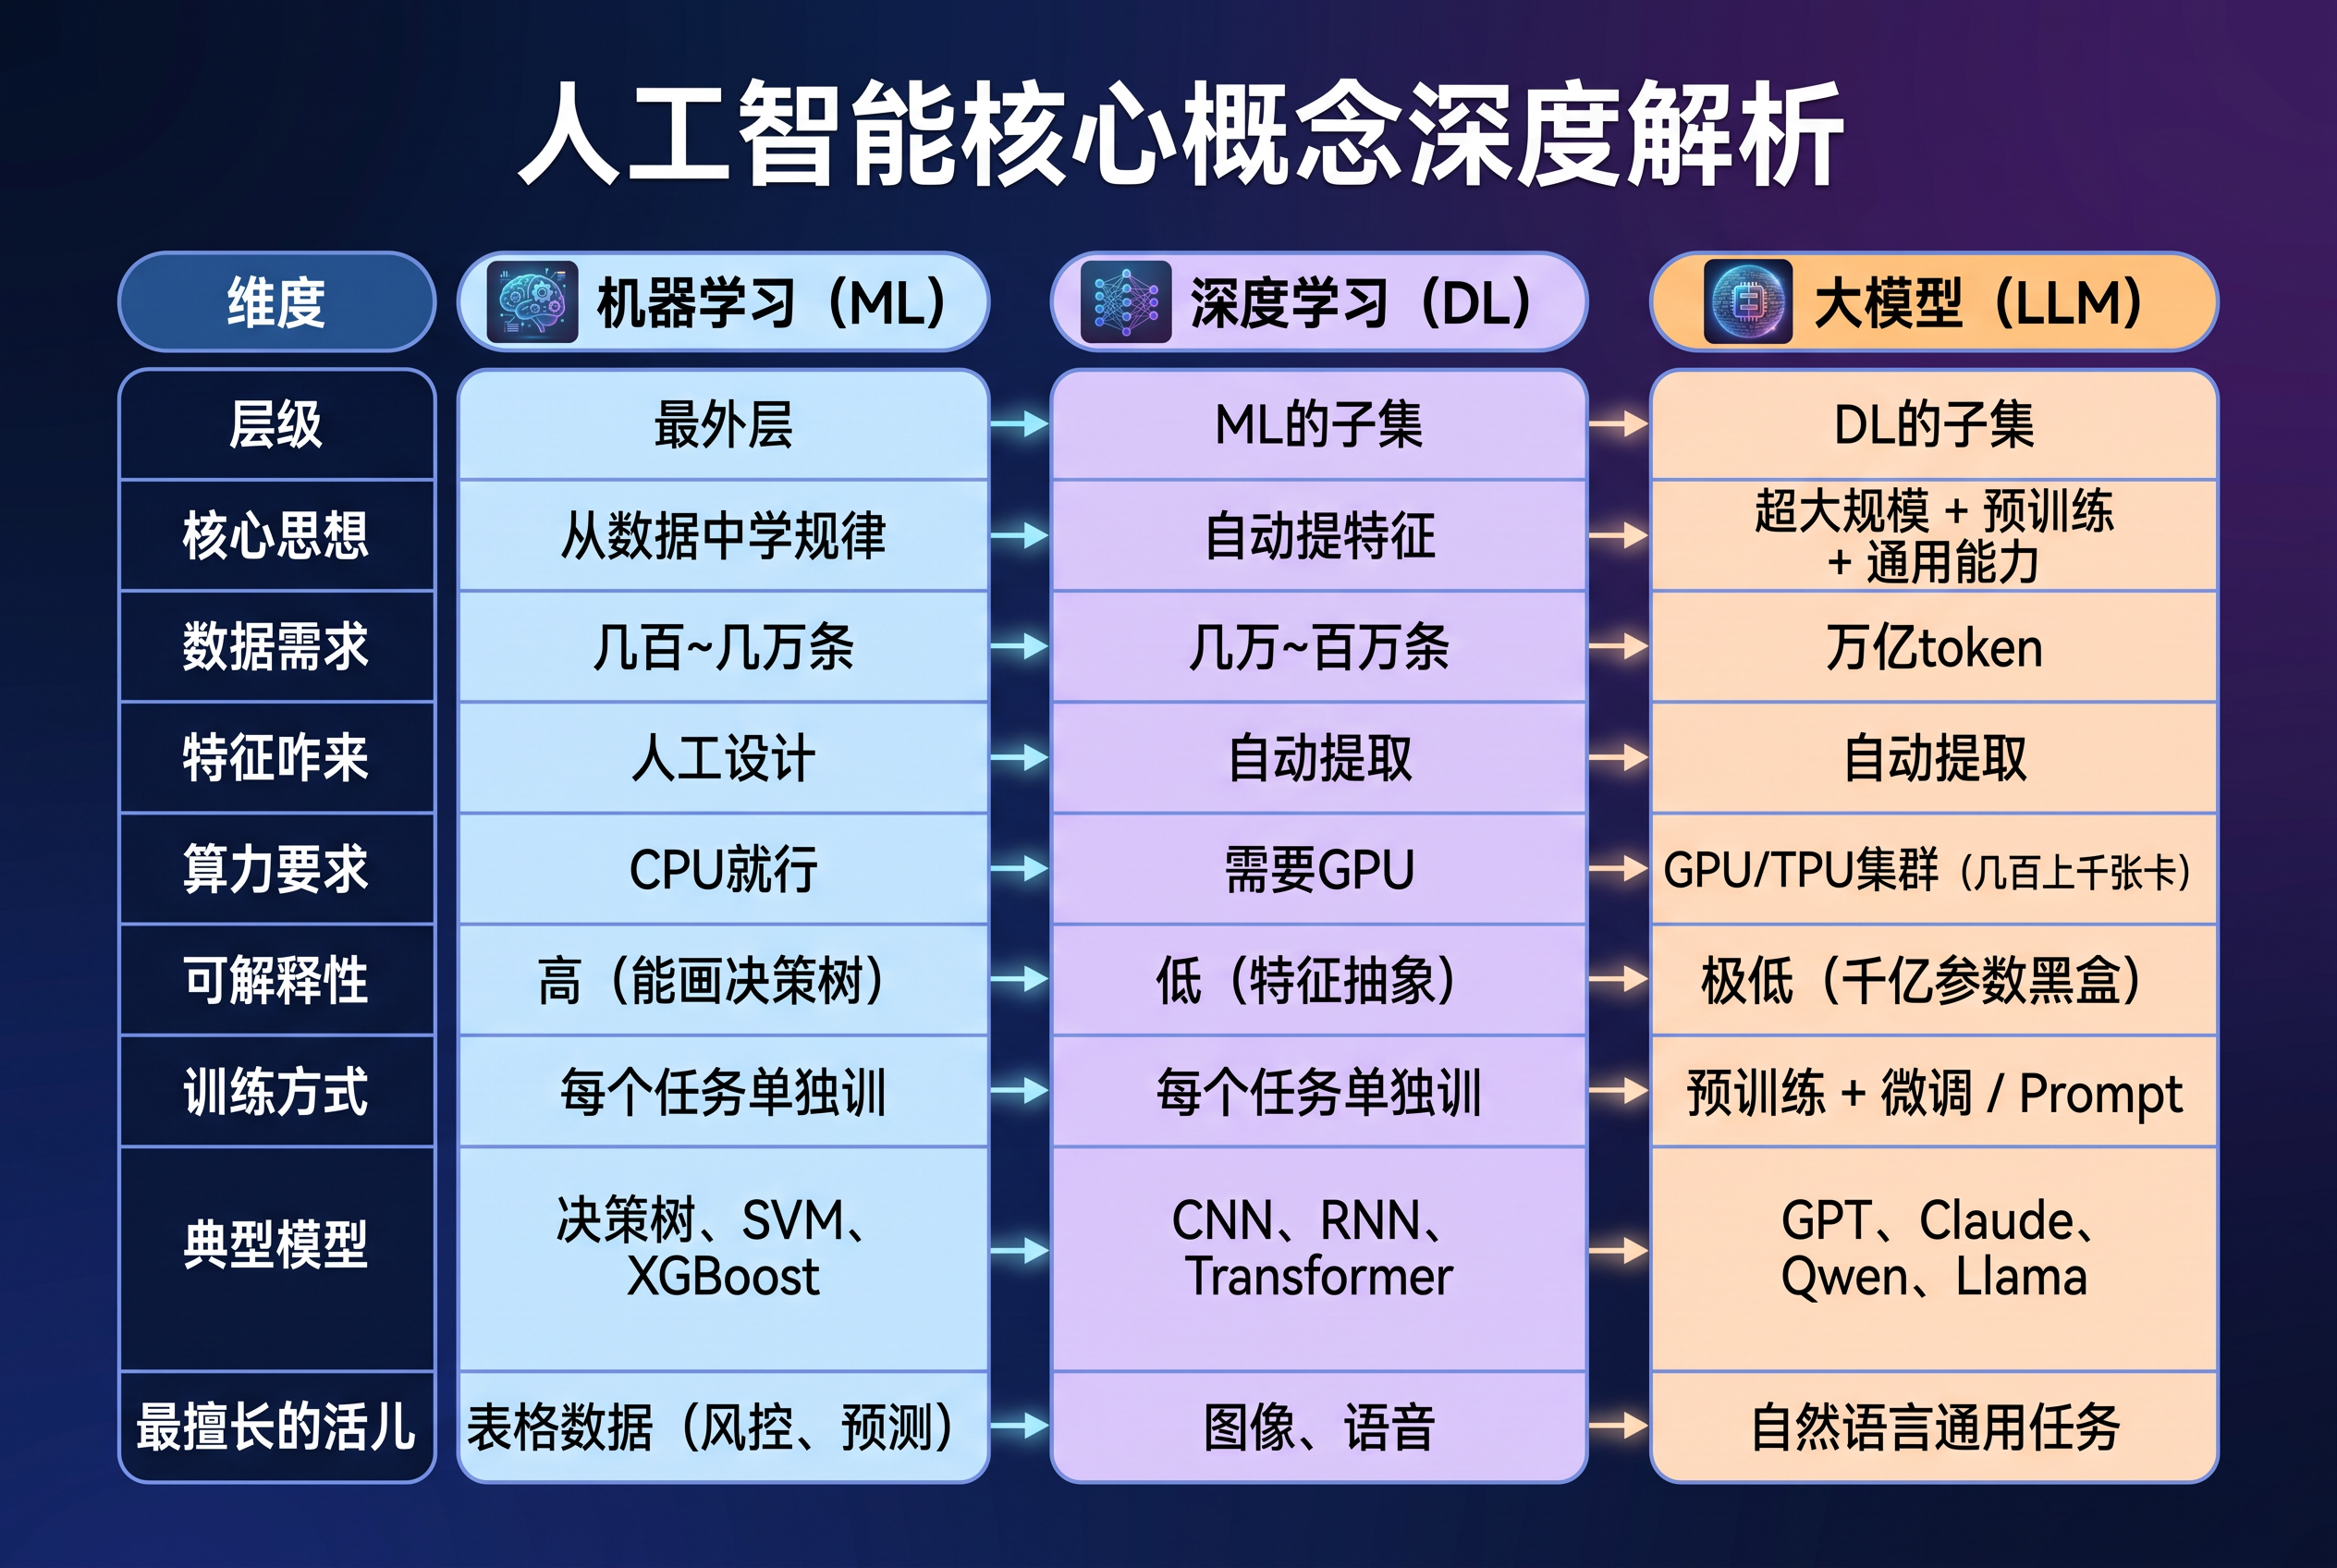
| 维度 | 机器学习 (ML) | 深度学习 (DL) | 大模型 (LLM) |
| 层级 | 最外层 | ML的子集 | DL的子集 |
| 核心思想 | 从数据中学规律 | 自动提特征 | 超大规模 + 预训练 + 通用能力 |
| 数据需求 | 几百~几万条 | 几万~百万条 | 万亿token |
| 特征咋来 | 人工设计 | 自动提取 | 自动提取 |
| 算力要求 | CPU就行 | 需要GPU | GPU/TPU集群(几百上千张卡) |
| 可解释性 | 高(能画决策树) | 低(特征抽象) | 极低(千亿参数黑盒) |
| 训练方式 | 每个任务单独训 | 每个任务单独训 | 预训练 + 微调 / Prompt |
| 典型模型 | 决策树、SVM、XGBoost | CNN、RNN、Transformer | GPT、Claude、Qwen、Llama |
| 最擅长的活儿 | 表格数据(风控、预测) | 图像、语音 | 自然语言通用任务 |
三、为啥会有这些差异?
数据量需求跟参数量正相关。经验上数据量至少是参数量的10~100倍。ML参数少,千条数据就能跑;DL参数多,需要更多样本;LLM千亿参数,只能用万亿token去喂。
自动提特征靠的是多层非线性变换。底层看边缘,中层看轮廓,高层看语义。层数越深,抽象程度越高,但人也越看不懂它在干啥。
算力需求跟矩阵运算的并行度挂钩。ML的算法偏串行,CPU足够;DL是矩阵乘法,GPU天生适合;LLM单卡放不下,必须上多卡集群+分布式框架。
可解释性跟特征抽象程度反相关。决策树能画图给监管看,DL只能靠SHAP、LIME猜,LLM基本没法解释——这也是对齐问题(alignment)难搞的原因。
四、重叠地带:三种都能做时怎么选?
以文本分类为例:
| 方案 | 数据量 | 训练成本 | 推理成本 | 准确率 | 可解释性 |
| TF-IDF + SVM | 5000条 | CPU/小时 | 极低 | 80% | 高 |
| 微调BERT | 5000条 | GPU/天 | 中等 | 90% | 低 |
| Prompt + GPT | 0条(零样本) | 0 | 高(API费用) | 92% | 极低 |
准确率从80%到92%,但成本是1倍、10倍、100倍的关系。怎么选?看下面:
| 情况 | 建议 |
| 预算紧 + 数据多 + 要解释 | → 传统ML(XGBoost、逻辑回归) |
| 数据足 + 追求极致精度 + 速度敏感 | → 深度学习(PyTorch、CNN/RNN) |
| 数据少 + 任务通用 + 对延迟不敏感 | → 大模型(Prompt或微调) |
五、真实场景直接给方案
场景1:银行风控(贷款批不批)
数据是表格(年龄、收入、征信)
必须能解释(合规审计要求)
→ 上XGBoost或逻辑回归。别无脑上大模型,又贵又说不清为啥拒贷。
场景2:工厂质检(图像缺陷检测)
输入是图片,缺陷类型固定
已有大量标注数据
→ 用CNN(YOLO、ResNet这类)。准确率能干到99%以上,没必要调大模型API,慢且贵。
场景3:科研助手(文献总结、写代码、查资料)
任务开放、多样,没法穷举
→ 上大模型(DeepSeek、Qwen本地部署,或GPT/Claude云端API)。
入门路径:
刚开始:ChatGPT/Claude 网页版,快速问问题
进阶:本地跑 Ollama + DeepSeek/Qwen,处理私有数据
深度:用 API + LangChain 搭自动化工作流
六、三个最重要的认知
包含关系,不是并列关系。大模型能做的,深度学习理论上也能做,只是成本和难度完全不是一个级别。
自动化程度 = 参数量的扩张。从“学映射”到“学特征”到“学任务”,每一次跃迁都是参数规模的指数级增长。
没有最好,只有最合适。先看数据长啥样(表格/图像/文本),再看要不要解释,最后看预算。三者各有各的适用场景。
一句话口诀:
表格数据 → 机器学习(Scikit-learn、XGBoost)
图像/语音 → 深度学习(PyTorch、CNN/RNN)
开放文本任务 → 大模型(Transformers、Prompt工程)
评论
安
干货推荐
计算机材料设计Materials-Studio教程11
活着
35 1
计算机材料设计Materials-Studio教程3
活着
33 1
计算机材料设计Materials-Studio教程12
活着
44 2
有髓神经纤维超微结构
Mr弘🔬
56 5
模态分析到底在算啥?搞懂这个,结构为什么会自己振动就明白了
莫名其妙
63 4
分子轨道理论简介与计算示例
天玑智研
769 6