
AI丨麦吉尔大学Ding Lab课题组 Nat Commun: 通过基于深度生成模型和主动学习的半测序方法推进大规模单细胞研究
第一作者:王靖韬
通讯作者:丁俊
通讯单位:麦吉尔大学
论文DOI:https://doi.org/10.1038/s41467-024-50150-1
全文速览
该论文介绍scSemiProfiler (单细胞半测序器):一种结合深度生成人工智能和主动学习的计算工具,通过使用bulk 测序数据和代表性样本的单细胞测序数据模板对队列研究中的样本进行“半测序”分析。scSemiProfiler仅需1/10到1/3的成本,就能生成与真实测序数据集非常相似的半测序数据集,能够确保高度一致的单细胞水平下游分析。
背景介绍
单细胞测序是生物研究中的一项突破性技术,通过提供单个细胞层面的细胞状态信息,深入洞察细胞复杂性。这项技术对于识别和表征患者样本中的各种细胞亚群至关重要,推动了生物标志物发现和个性化治疗的重大进展。然而,其高昂的成本极大地限制了其在复杂疾病队列等大规模研究中的应用。在本研究中,我们利用深度生成AI和主动学习,大幅降低成本,实现了为大规模单细胞研究提供半测序单细胞数据。
成本挑战
单细胞测序是革命性的,但成本高得令人望而却步。例如,根据2023年麦吉尔大学健康中心的估算,对20,000个细胞进行测序的费用大约为6,000美元,这使得大规模研究项目变得不切实际。为了降低成本,研究人员使用了“去卷积”(deconvolution)方法,例如CIBERSORTx,从更经济的bulk测序数据中推断细胞类型比例。虽然这些方法很有用,但它们只能提供细胞群体水平的估计,缺乏单细胞水平分析所需的更详细分辨率,而单细胞分析对于理解复杂疾病和治疗探索至关重要。
开发“半测序”方法
为了利用经济实惠的bulk数据中的信息来提供更具成本效益的单细胞数据,我们设计了一种深度生成AI方法,结合主动学习,精确且高效地对疾病队列进行单细胞水平的“半测序”。整个框架可以大致分为两个主要部分,这两个部分对于提供准确有效的半测序至关重要:选择最佳代表性单细胞样本(代表选择 representative sample selection)和在计算机中利用bulk数据推断目标单细胞数据(单细胞数据推断in silico inference)。
方法总结
使用深度生成学习模型进行单细胞数据推算
最关键的部分是,给定代表性样本的单细胞参考数据,如何将bulk数据去卷积为单细胞数据?我们通过利用bulk数据和单细胞数据之间的关系来解决这个问题,即bulk数据是单细胞数据的平均值。因此,如果一个模型正在为一个只有bulk数据的目标样本生成单细胞数据,那么生成的单细胞数据的平均值应该与其bulk数据相似。基于这一理解,我们设计了方法:一个深度生成学习模型首先重建代表性样本的单细胞参考数据,然后通过要求生成的单细胞数据的平均值与目标样本的bulk数据相似来引入目标样本的信息。
使用主动学习进行代表性样本选择
有了计算推断方法,如何选择代表性样本以使其单细胞参考数据最大化推断性能?一种直观的方法是,我们可以根据bulk数据对样本进行聚类,并选择最接近聚类中心的样本。然而,通常很难预先决定代表性样本的数量。因此,我们采用了主动学习,一类用于迭代选择最有信息量样本的算法,以最大化机器学习模型的性能。我们根据bulk数据的聚类选择初始的代表样本,然后在随后的代表选择轮次中,使用主动学习算法进行迭代选择。在选择代表性样本的过程中,主动学习算法会考虑各方面因素:bulk数据信息、真实测序和通过模型来推算的单细胞数据信息以及模型的训练难度。新选择的代表性样本将进行真实单细胞测序,并用作新一轮单细胞计算推断步骤的新单细胞参考数据。基于主动学习的这种迭代代表性选择方法的优势在于用户可以随时停止继续单细胞测序以节约成本。
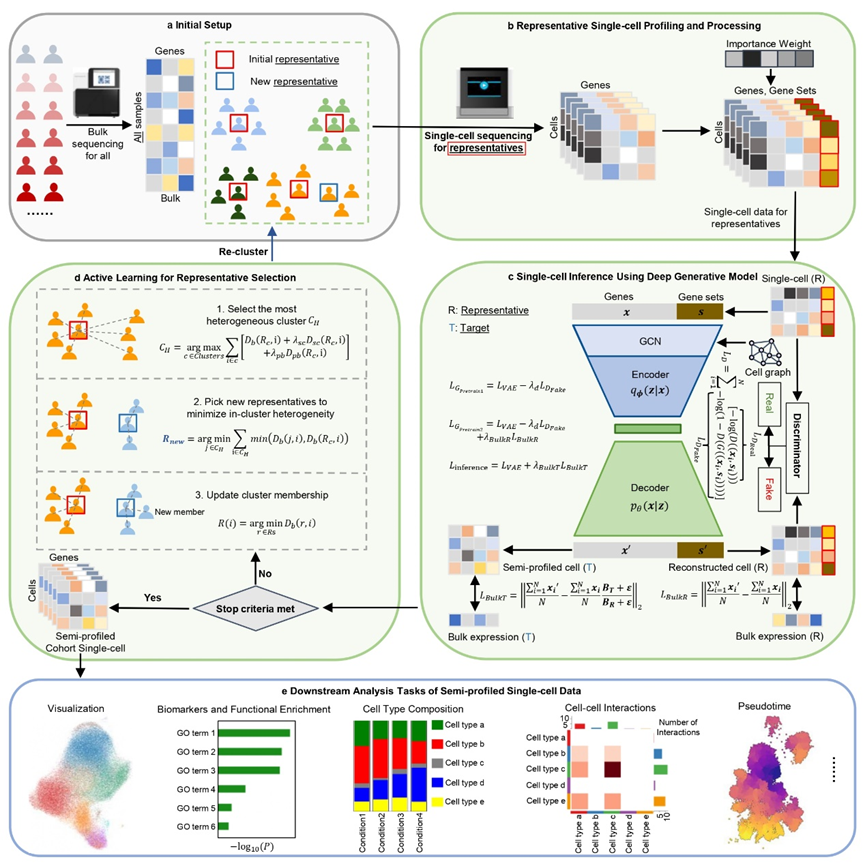
图1. scSemiProfiler(单细胞半测序器)方法概览 a 初始设置:对整个队列进行bulk测序。基于bulk数据的聚类分析选择初始代表性样本。b 代表性样本的单细胞测序和处理:对代表性样本进行单细胞测序。处理数据以提高深度学习模型的性能。c 使用深度生成模型进行单细胞推断:深度生成学习模型利用代表性样本的bulk数据和单细胞数据,为没有单细胞数据的目标样本推断单细胞数据。d 主动学习:应用主动学习算法进行额外的代表性样本选择。e 下游分析:半测序数据集可用于单细胞水平分析,产生与真实测序数据集相似的结果。
结果展示
我们在多样化的数据集上验证了scSemiProfiler,包括所有样本都有单细胞数据的大型疾病队列,以及每个样本都有单细胞和bulk数据的队列。结果表明,scSemiProfiler在所有数据集中始终生成与实际单细胞数据集非常匹配的半测序单细胞数据。这种准确性对于可靠的下游分析至关重要,包括可视化、生物标志物发现、解卷积、富集分析、细胞-细胞相互作用分析、拟时序等,这证明了scSemiProfiler用于大规模研究的可靠性和稳定性。
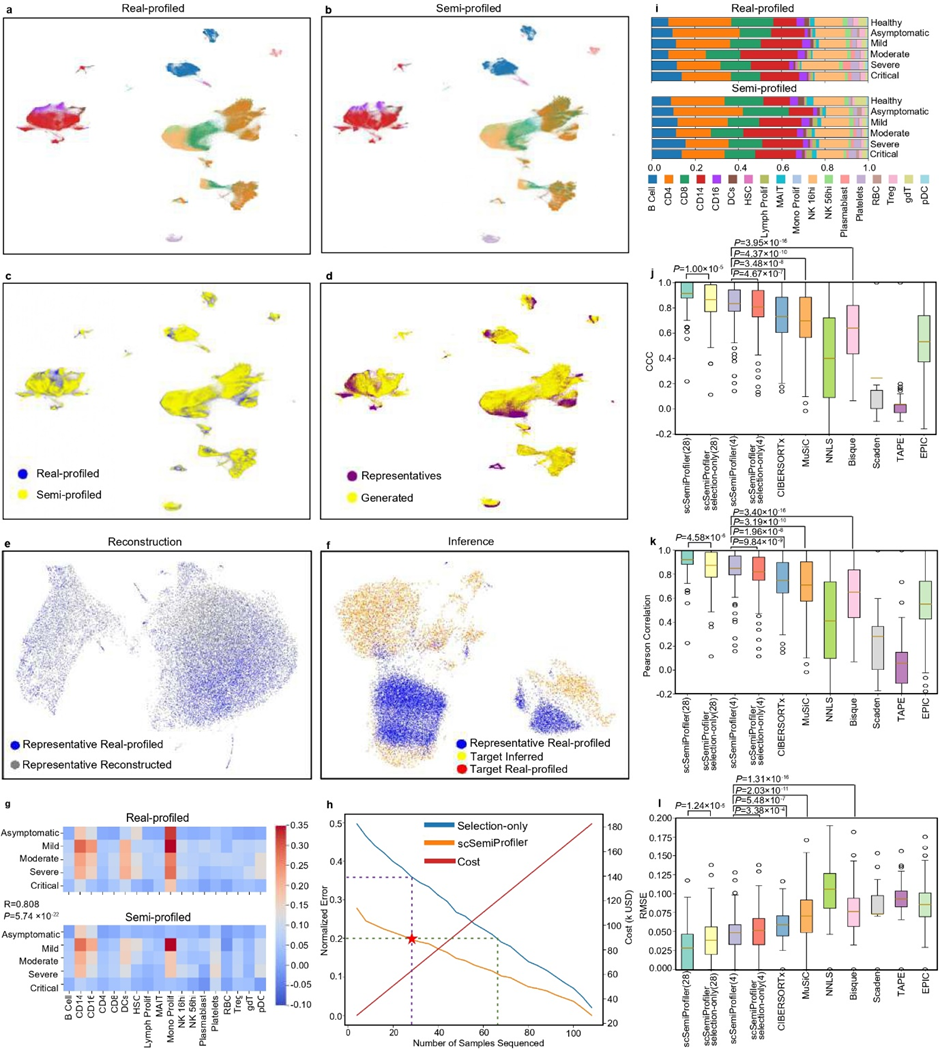
图2.COVID-19数据集上半测序数据集和真实测序数据集的比较。a,b 真实数据和半测序数据的UMAP可视化比较,颜色代表细胞类型,和i的颜色标注一致。c 真实数据和半测序数据放在一起可视化,高重合度表明高相似度. d 不同颜色表示半测序数据集中由深度生成模型产生的细胞和代表性样本的真实测序活得的细胞。e,f 两个目标样本的单细胞数据推断效果可视化 g 半测序和真实数据的interferon通路基因表达模式的对比 h 随着更多样本被选为代表性样本,半测序数据与真实数据的误差不断减小。我们的方法scSemiProfiler能得到比基线方法selection-only更低的误差。Selection-only方法选择相同的代表性样本,但是在为目标样本推算单细胞数据时仅拷贝代表样本的数据。i 半测序数据不同疾病状态的细胞构成和真实数据高度一致。j-l 半测序方法作为一种去卷积方法性能超越已有其他方法。
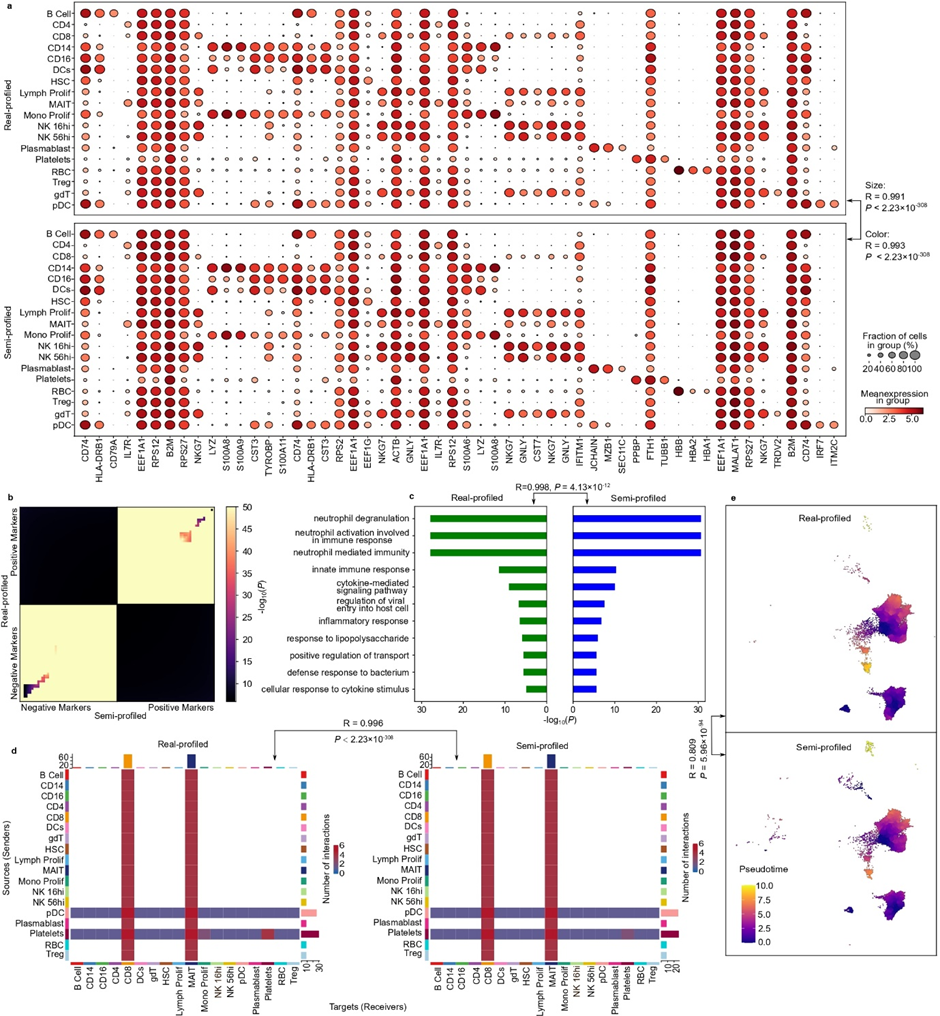
图3.COVID-19数据集上半测序数据集和真实测序数据集的下游任务比较。a 真实数据和半测序数据的细胞类型标志物表达模式一致。b RRHO图显示真实数据和半测序数据找到的细胞类型标志物高度一致。c 两个数据集的拟时许分析结果高度一致
总结与展望
scSemiProfiler(单细胞半测序器)在单细胞测序方面取得了重大进展,提供了一种可扩展低成本的获得单细胞数据的方案。通过克服成本障碍,scSemiProfiler使研究人员能够进行以前无法实现的大规模高分辨率研究。我们邀请研究人员尝试scSemiProfiler并考虑将其应用于他们的研究中。欲了解更多详细信息,参见我们在《自然通讯》上的论文 https://www.nature.com/articles/s41467-024-50150-1#Sec2
课题组/招聘
关于丁俊教授
丁俊教授,在中佛罗里达大学获得计算机科学博士学位。随后,他与Ziv Bar-Joseph(2012年奧弗顿奖获得者)在卡内基梅隆大学完成了为期四年的计算生物学博士后研究。2021年,他加入麦吉尔大学的医学系,担任终身教职助理教授。他同时附属于米金-克里斯蒂实验室,麦吉尔计算机学院,Mila-魁北克人工智能研究院。目前主要从事人工智能在医学领域内的应用研究,特别是AI疾病诊断和AI药物发现和设计
招聘职位:本科研究实习生
Dr. Jun Ding (https://junding.lab.mcgill.ca/) 正在寻找自我激励的本科研究实习生、硕士研究生和博士研究生加入他的实验室,实验室位于麦吉尔大学。我们的实验室专注于开发生命科学和健康领域的机器学习/深度学习应用,包括药物发现、理解肺癌中的细胞动态等。实验室拥有充足的资金和计算资源,包括GPU。
本科研究实习生
要求:
熟悉Python(熟悉PyTorch/TensorFlow者优先)
有强烈的研究兴趣(有研究经验者优先)
熟悉机器学习和深度学习(有概率图模型或图神经网络经验者优先)
福利:
表现良好的学生可获得推荐信
在实习期间发表影响因子大于5的期刊论文的学生可直接获得录用
如果您对任何职位感兴趣,请将您的简历发送至jun.ding@mcgill.ca。
原文链接:https://www.nature.com/articles/s41467-024-50150-1
评论
天玑智研

顶刊推荐

26.52%效率!重庆大学孙宽/关西大学郭昊轩Advanced Materials:多功能相变盐用于反式钙钛矿太阳能电池
陈沛冬
110 4

电催化丨王得丽教授/刘旭坡、陈野副教授Angew:配体诱导晶格羟基活化实现高效电合成2,5-呋喃二甲酸
刘旭坡
371 6

中山大学刘川/刘佰全&浙江大学狄大卫Advanced Materials:钙钛矿opto-DRAM开启屏内光学传感显示新篇章
刘佰全
245 6

AI丨麦吉尔大学Ding Lab课题组 Nat Commun: 通过基于深度生成模型和主动学习的半测序方法推进大规模单细胞研究
王靖韬
310 2

固态电池丨北理工黄佳琦教授、袁洪教授最新Adv Mater:本质安全不燃的固态金属锂电池
杨世杰
411 7