
麦吉尔大学Ding Lab课题组Genome Biology:用于实现单细胞多组学无缝集成、跨模态生成和计算模拟探索的模型
第一作者:杨秀辉
通讯作者:吴昊,丁俊
通讯单位:山东大学
论文DOI:https://doi.org/10.1186/s13059-024-03338-z
全文速览
该论文介绍了scCross,一种深度生成模型,旨在集成单细胞多组学数据,并提供无缝的跨模态生成和探索功能。scCross能够高效生成跨模态数据,模拟多组学数据,并处理不同模态之间的计算扰动。借助其强大的跨模态生成和扰动能力,scCross有望突破当前生物技术中某些组学(相对于单细胞转录组)的获取难度限制。该框架通过无缝集成和跨模态生成,大大提升了单细胞多组学数据的实用性和探索潜力,为获取全面且详细的生物学见解提供了全新的机会。
背景介绍
单细胞测序技术的引入标志着生物研究的新时代,使科学家能够以前所未有的细节分析细胞异质性。这一突破揭示了复杂的细胞动态,并在癌症生物学、神经生物学和药物发现等领域产生了深远的影响。然而,这些技术产生的数据通常极为复杂和多样化,导致许多现有计算工具仅能处理有限的分析任务。
多组学数据集成和生成中的挑战
有效集成单细胞多组学数据仍然是该领域的一项重大挑战。许多现有方法依赖于匹配的多组学数据集,而这些数据集通常难以获取,从而限制了分析的范围。这些限制导致了未匹配数据的集成不足,并在处理噪声和信息丢失上面临困难。即使是旨在处理多数据模态的方法,也面临提取跨模态共同特征和管理非线性转换等持续挑战。不同组学数据类型的可用性不平衡进一步加剧了这一问题,例如,单细胞表观基因组学数据的获取难度远高于转录组学数据。这种稀缺性不仅阻碍了多组学分析,也限制了发现全面生物学见解的潜力。这些挑战突显了对更强大和灵活的集成与生成方法的迫切需求,以克服现有的不足和限制。
方法总结
开发集成方法用于集成、生成、扰动和后续分析
为了解决这些挑战,我们提出了scCross。这一方法在集成单细胞多组学数据方面表现出色,并因其独特的跨模态数据生成能力而别具一格。这种能力弥合了丰富与稀缺的数据模态,从而更全面地描绘细胞状态。scCross的另一个关键特性是其对单细胞多组学数据的高保真模拟以及对计算扰动的支持,使得基于数据集成的模拟细胞干预实验成为可能,从而探索潜在的基因干预策略。通过深入了解跨模态细胞动态,scCross不仅提升了单细胞多组学研究的实用性,还推动了该领域的创新和发展。
利用深度生成框架集成多组学
scCross模型用于集成和生成单细胞多组学数据,结合了变分自编码器(VAEs)和生成对抗网络(GANs)以构建深度生成框架。该框架实现了单细胞多组学数据的无缝集成、跨模态数据生成、多组学数据模拟以及计算扰动。具体而言,首先通过训练VAEs来捕获低维细胞嵌入,并利用基因集向量来丰富信息的深度。这些嵌入随后被整合到一个共同的潜在空间中,并通过应用Jensen-Shannon(JS)散度损失来最小化不同组学间的数据分布差异。接着,GANs被用于在这一共同潜在空间中融合不同模态的数据。为了进一步优化集成过程,scCross使用了互为最近邻(MNN)细胞对作为锚点,以指导对齐过程。这一方法确保了在共同潜在空间中,相同或相似的细胞的嵌入在不同模态中保持接近,从而实现了模态数据的协调集成和分布,确保了多组学数据集成的稳健性和准确性。
使用双向对齐进行跨模态生成
除了单细胞多组学数据的集成,scCross模型还支持跨模态单细胞数据的生成和扰动。在这一过程中,双向对齐器发挥了关键作用,它能够将共享的潜在嵌入解码为不同的模态。一旦训练完成,模型可以通过将一种模态的数据编码到潜在空间中,然后解码生成另一种模态的数据,从而实现跨模态单细胞数据的生成。此外,scCross能够模拟多组学数据的生成,并处理模态内外的计算扰动,揭示细胞状态中的潜在调节变化。通过将单细胞多组学数据整合到一个统一的潜在空间,并支持跨模态集成,scCross为一系列单细胞多组学应用提供了坚实的基础,尤其是在某些组学数据有限或不可用的情况下。
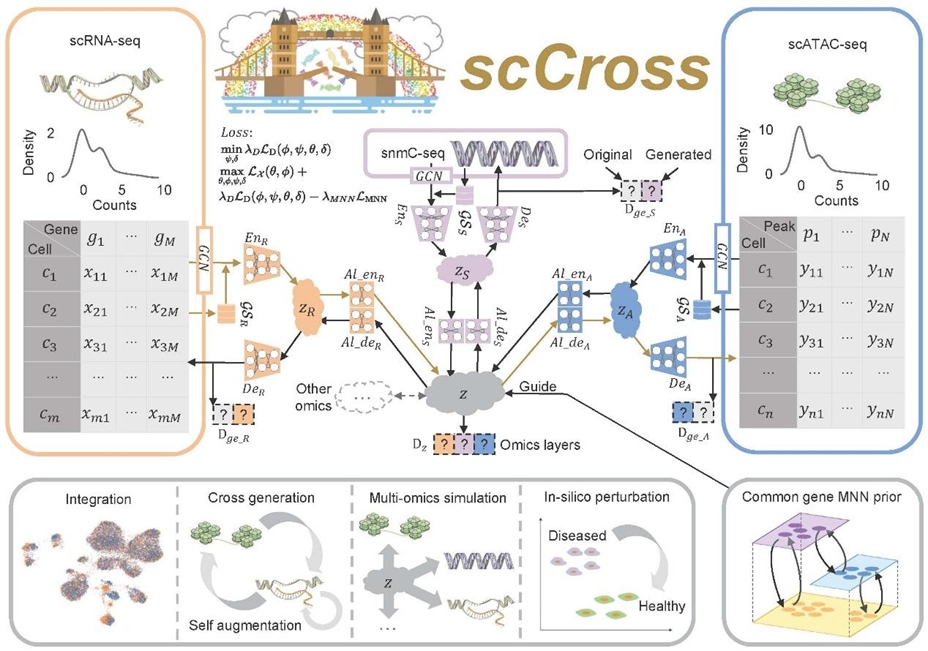
图1. scCross方法概览。scCross使用特定模态的变分自编码器来捕捉每种组学的细胞潜在嵌入。在单细胞数据整合过程中,该方法通过将基因集矩阵等作为附加特征来融入生物学先验。同时,该方法利用进一步的变分自编码器和双向对齐器,将这些信息丰富的嵌入整合为共享嵌入z。双向对齐器在跨模态生成中发挥了关键作用,棕色箭头表示从scRNA-seq到scATAC-seq的过渡。互近邻先验确保了对齐过程的精确性。判别器则负责维护不同组学的整合,同时确保生成数据的完整性和一致性。scCross提供了一个强大的工具箱,用于单细胞数据整合,支持跨模态数据生成、单细胞数据增强、单细胞多组学模拟以及计算模拟扰动,使其在解决多种单细胞多组学挑战时具有极大的灵活性。
结果展示
我们在多样化的数据集上验证了scCross,所有样本都有多种单细胞组学数据。结果表明,scCross在这些数据集上有着良好的单细胞多组学数据集成,跨模态生成,多模态模拟与计算扰动性能,这可以通过多种指标与下游分析进行验证。这种优越的性能为科学界提供了全面掌握单细胞多组学视野与跨模态细胞动力学的可能性。这同时证明了scCross用于大规模研究的可靠性和稳定性。
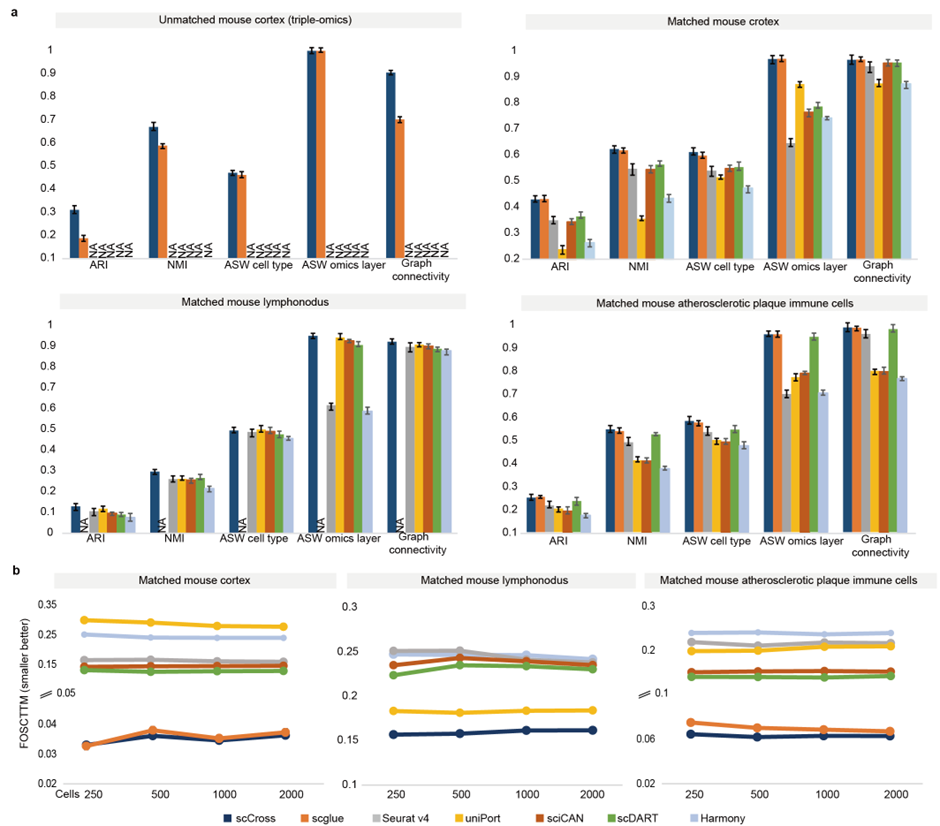
图2.评估scCross在单细胞多组学数据整合中的优越性。a,全面的比较分析展示了scCross相对于其他整合方法的可比或更优表现。指标如细胞类型的平均ARI、NMI得分和ASW提供了整合后的单细胞多组学数据集的聚类质量洞察,表明整合后生物特征的保留。此外,组学层次的ASW和图连接性指标揭示了不同组学在整合后的有效混合情况。研究的数据集包括未匹配和匹配的小鼠皮层、匹配的小鼠淋巴结以及匹配的小鼠动脉粥样硬化斑块免疫细胞。“NA”表示结果无法获得的情况(例如,方法不支持三组学整合或仅获得非数值输出)。b,FOSCTTM得分进一步强调了scCross在不同规模的子样本数据集上的卓越表现,展示了其相较于其他整合技术的一致的可比或更好表现。本部分深入探讨了如匹配的小鼠皮层、匹配的小鼠淋巴结以及匹配的小鼠动脉粥样硬化斑块免疫细胞等数据集。
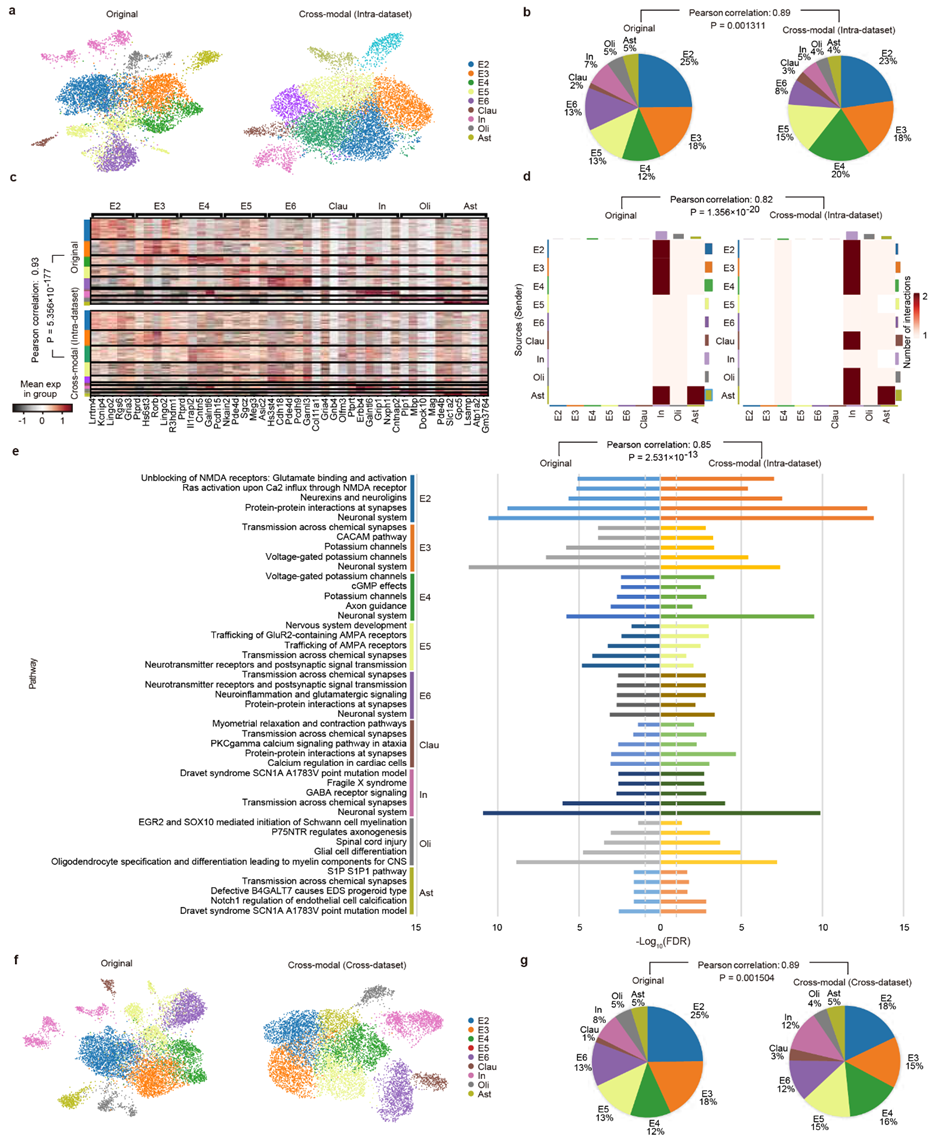
图3.在跨模态单细胞数据生成中,scCross的表现:重点关注实际数据和跨生成数据之间的相似性。a-e,模型在部分数据集上训练时的结果:a,UMAP可视化突出了原始数据与跨生成的scRNA-seq数据之间的重叠分布。b,细胞类型比例的比较显示了0.89的强相关性(P = 0.001311)。c,每种细胞类型的前5个基因的表达水平显示了0.93的相关性(P = 5.356 × 10−177)。d,细胞间相互作用指标显示了细胞类型之间的一致性,相关性为0.82(P = 1.356 × 10⁻²⁰)。e,每种细胞类型在最重要通路中的基因比例验证了原始数据和跨生成数据集之间的0.85相关性(P = 2.531 × 10⁻¹³)。f-g,模型在独立参考多组学数据集上训练时的结果:f,UMAP可视化展示了原始数据和跨生成的匹配小鼠scRNA-seq数据之间的聚类相似性。g,细胞类型比例强调了原始数据和跨生成的scRNA-seq数据之间的0.89相关性(P = 0.001504)。
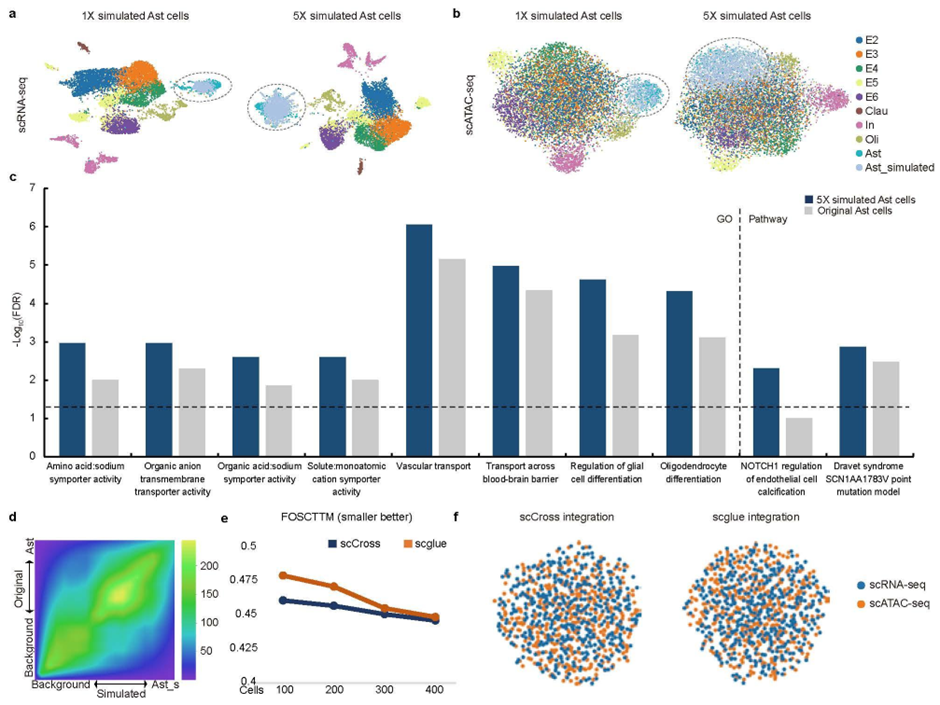
图4.scCross具备模拟生成任意数量的特定细胞类型的单细胞多组学数据能力。a,UMAP可视化展示了scCross在模拟匹配小鼠皮层数据集中稀有Ast细胞scRNA-seq数据方面的能力(用灰色圆圈突出显示),以原始数据的1X和5X倍数进行展示,整个原始数据集作为聚类背景。5X倍数突出了模型在放大稀有群体(如Ast细胞)表现的能力。b,与面板a平行,这一UMAP可视化展示了Ast细胞的模拟scATAC-seq数据,在1X和5X倍数下(用灰色圆圈突出显示),强调了模型在不同组学模态下的持续表现。c,分析对比了原始星形胶质细胞(Ast)(scRNA-seq)的顶级生物标志物与其5X倍数增强模拟等效物的Gene Ontology (GO) 术语和通路的富集情况。这一比较突显了模型在多组学数据模拟框架内放大关键生物信号的能力。d,RRHO图强调了原始Ast scRNA-seq数据与其1X倍数模拟数据之间的显著相关性。这突出了模型在模拟过程中准确捕捉关键生物标志物基因的能力。e,FOSCTTM整合指标突出了1X倍数模拟的Ast细胞单细胞多组学数据(涵盖scRNA-seq和scATAC-seq)作为评估基准的潜力。虽然scCross和scglue都被比较,但应注意由于数据来源的固有偏见对scCross的偏向。f,UMAP可视化显示了在处理1X倍数模拟的Ast细胞单细胞多组学数据时,scglue和scCross所实现的强大细胞混合能力,生动展示了它们各自的能力。
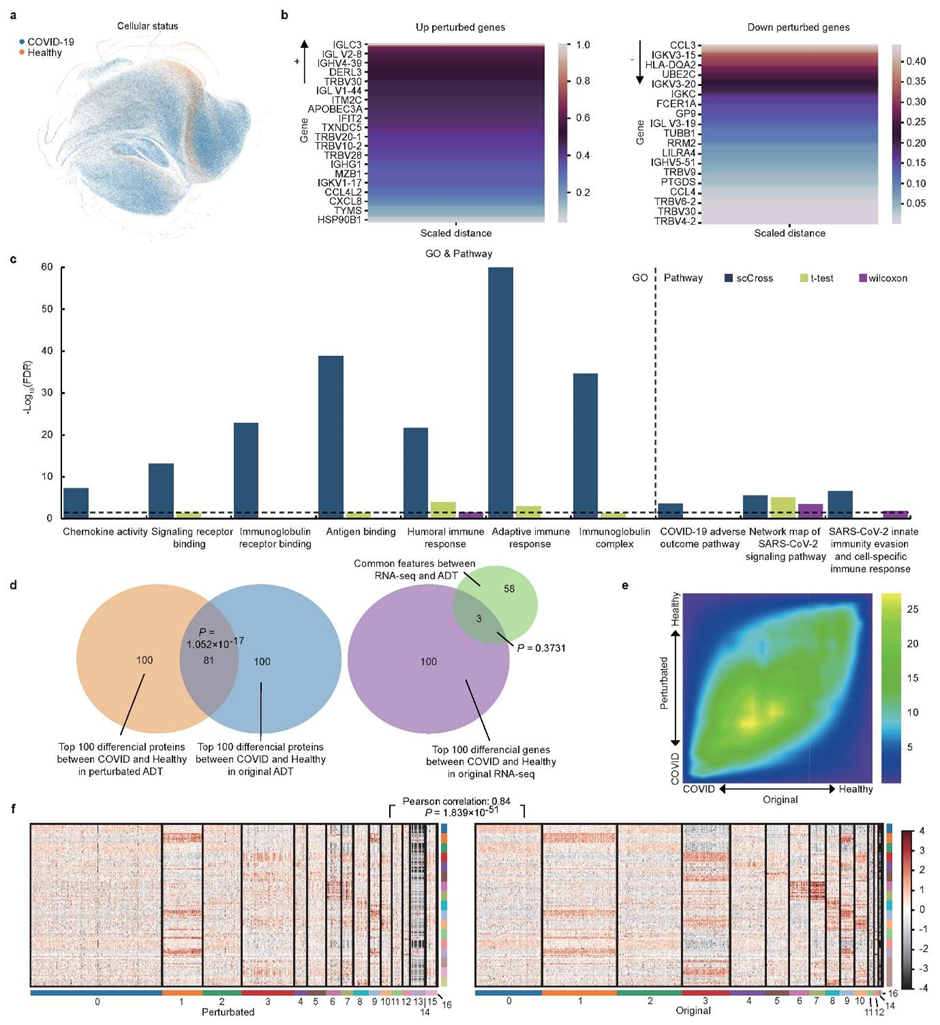
图5.scCross在COVID-19数据集中的多组学模拟扰动能力,其中a-f展示了scCross利用扰动发现关键差异基因的能力,d-f展示了scCross跨模态扰动保留的能力。a,UMAP可视化展示了COVID-19的scRNA-seq和ADT数据集群。b,展示了用于在计算扰动中连接COVID-19与健康状态的标志基因。c,展示了scCross检测的主要差异基因的通路和GO术语(下扰动基因发现),其中-log(p值)指示了显著性,并与t检验和Wilcoxon检验结果进行了比较。d,对比了scCross派生的扰动蛋白数据与基于scRNA-seq到蛋白质翻译的常见基因的基因数据。e,RRHO图比较了跨模态扰动的COVID-19蛋白数据与健康样本的原始数据。f,热图比较了原始的COVID-19蛋白数据与scCross派生的扰动数据的一致性。
总结与展望
scCross 方法为单细胞研究界展现了巨大的潜力。其独特的功能和可靠的性能使其成为单细胞多组学分析领域研究人员的潜在有价值的工具。scCross 促进不同模态的集成,支持全面的数据生成,并实现详细的模拟和扰动。这些能力可以极大地促进复杂生物系统的研究。我们邀请研究人员尝试scCross并考虑将其应用于他们的研究中。欲了解更多详细信息,参见我们在《基因组生物学》上的论文https://genomebiology.biomedcentral.com/articles/10.1186/s13059-024-03338-z
课题组招聘
关于丁俊教授
丁俊教授于2021年3月加入麦吉尔大学医学院,担任终身教职轨道助理教授。他还隶属于Meakins-Christie实验室、定量生命科学,并将隶属于计算机科学系。在加入麦吉尔大学之前,他在卡内基梅隆大学与Ziv Bar-Joseph(2012年Overton奖得主)完成了博士后研究。
招聘职位:本科研究实习生
Dr. Jun Ding (https://junding.lab.mcgill.ca/) 正在寻找自我激励的本科研究实习生、硕士研究生和博士研究生加入他的实验室,实验室位于麦吉尔大学。我们的实验室专注于开发生命科学和健康领域的机器学习/深度学习应用,包括药物发现、理解肺癌中的细胞动态等。实验室拥有充足的资金和计算资源,包括GPU。
本科研究实习生
要求:
熟悉Python(熟悉PyTorch/TensorFlow者优先)
有强烈的研究兴趣(有研究经验者优先)
熟悉机器学习和深度学习(有概率图模型或图神经网络经验者优先)
福利:
表现良好的学生可获得推荐信
在实习期间发表影响因子大于5的期刊论文的学生可直接获得录用
如果您对任何职位感兴趣,请将您的简历发送至jun.ding@mcgill.ca。
原文链接:https://genomebiology.biomedcentral.com/articles/10.1186/s13059-024-03338-z
评论
天玑智研

顶刊推荐

固态电池丨北理工黄佳琦教授、袁洪教授最新Adv Mater:本质安全不燃的固态金属锂电池
杨世杰
411 7

中山大学刘川/刘佰全&浙江大学狄大卫Advanced Materials:钙钛矿opto-DRAM开启屏内光学传感显示新篇章
刘佰全
245 6

26.52%效率!重庆大学孙宽/关西大学郭昊轩Advanced Materials:多功能相变盐用于反式钙钛矿太阳能电池
陈沛冬
110 4

AI丨麦吉尔大学Ding Lab课题组 Nat Commun: 通过基于深度生成模型和主动学习的半测序方法推进大规模单细胞研究
王靖韬
310 2

电催化丨王得丽教授/刘旭坡、陈野副教授Angew:配体诱导晶格羟基活化实现高效电合成2,5-呋喃二甲酸
刘旭坡
371 6