课程标题: 强化学习基础与实例应用
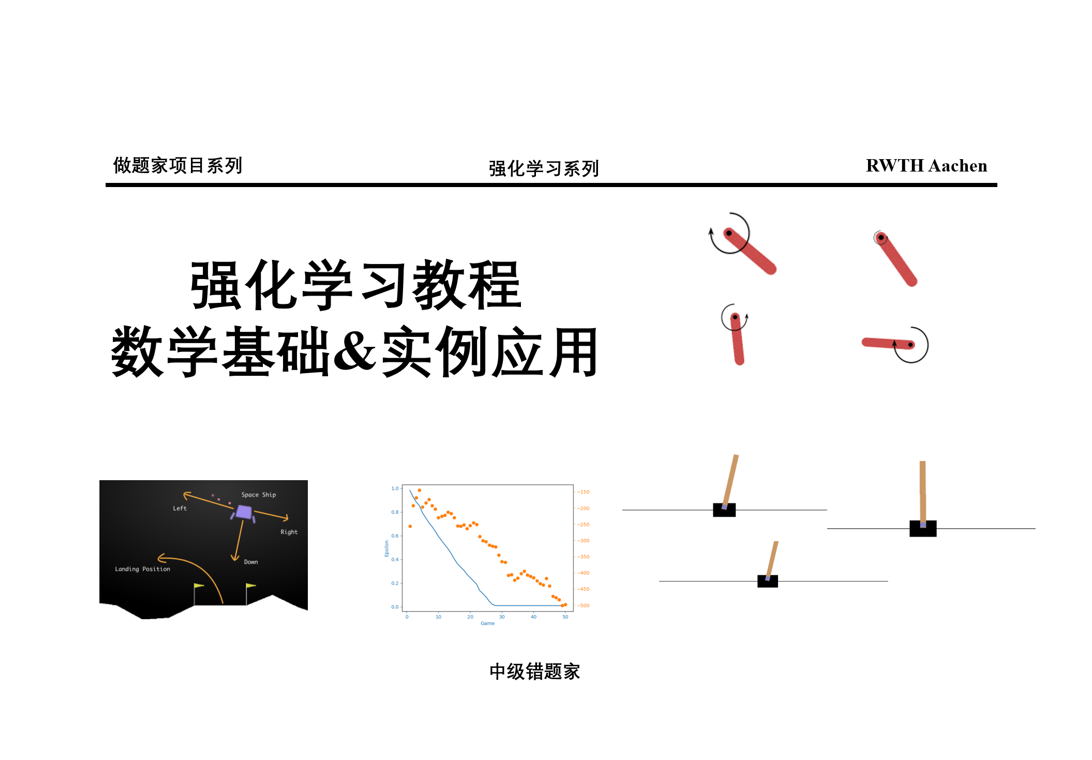
课程介绍:本课程通过实践带领学习者深入理解强化学习的基本概念及其应用。第一课将介绍强化学习的基础知识,并使用Gym和Baselines3库,带领学员训练一个月球登录器的强化学习模型。后续课程将进一步讲解模型的保存与加载、自定义环境下的训练、Q-learning基础、以及从零实现的Deep Q Learning算法。此外,课程还包含策略梯度法与A2C、DDPG等先进算法的实际操作,以实现对平衡车和单摆的控制。本课程适合希望从理论到实践系统学习强化学习的学员。
本课程同步自哔哩哔哩up主:中级错题家
第一课:基础知识介绍&月球登录器的强化学习模型训练
【强化学习1基础知识介绍&月球登录器的强化学习模型训练 gym baselines3】 https://www.bilibili.com/video/BV14Q4y1p7A5/?share_source=copy_web&vd_source=abe71bbf41e922a6a34166946ba4609c
第二课:月球登录器的强化学习模型 保存 & 加载
【强化学习教程2: 月球登录器的强化学习模型 保存 & 加载】 https://www.bilibili.com/video/BV1uM411R7HH/?share_source=copy_web&vd_source=abe71bbf41e922a6a34166946ba4609c
第三课:使用自定义gym环境训练贪吃蛇强化学习模型
【强化学习教程3: 使用自定义gym环境训练贪吃蛇强化学习模型】 https://www.bilibili.com/video/BV1tH4y197te/?share_source=copy_web&vd_source=abe71bbf41e922a6a34166946ba4609c
第四课:基于Q-learning的ice-lake游戏
【[重置版]强化学习教程4:Q-learning 游戏 ice lake python gym】 https://www.bilibili.com/video/BV1KM41197L7/?share_source=copy_web&vd_source=abe71bbf41e922a6a34166946ba4609c
第五课: 基于Q-learning的月球登录器游戏
【[重置版]强化学习教程5:从零开始实现Deep Q Learning 使用pytorch 操纵月球登录器】 https://www.bilibili.com/video/BV1sQ4y187EN/?share_source=copy_web&vd_source=abe71bbf41e922a6a34166946ba4609c
第六课:基于策略(policy-based)强化学习训练平衡车
【[重置版]强化学习教程6: 基于策略强化学习训练平衡车 bp神经网络 策略梯度】 https://www.bilibili.com/video/BV1ve411f7wQ/?share_source=copy_web&vd_source=abe71bbf41e922a6a34166946ba4609c
第七课:基于actor critic(A2C)算法实现平衡车的控制
【[重置版]强化学习系列教程7: A2C actor critic 算法 实现平衡车的控制】 https://www.bilibili.com/video/BV1Kg4y1C76p/?share_source=copy_web&vd_source=abe71bbf41e922a6a34166946ba4609c
第八课:基于DDPG算法实现单摆的控制
【[重置版]强化学习系列教程8:DDPG 算法 实现单摆的控制 || A2C算法变种】 https://www.bilibili.com/video/BV1JN4y1z724/?share_source=copy_web&vd_source=abe71bbf41e922a6a34166946ba4609c